 N環球

جوجل تكشف عن TPU 8tx و8i Max، رابع شرائح الذكاء الاصطناعي الخاصة بها هذا العام في تحدي لـ Nvidia
أعلنت Google Cloud عن نظامين جديدين من الجيل الثامن من مادة TPU، وهما TPU 8tx للحوسبة السرية وTPU 8i Max للنوافذ ذات السياق الضخم؛ وهذا هو العام الأول الذي تقوم فيه جوجل بشحن أربعة أنظمة من مادة TPU، ويتوقع المحللون أن ترتفع المبيعات المرتبطة بمادة TPU من حوالي 12 مليار دولار هذا العام إلى أكثر من 135 مليار دولار بحلول عام 2028.
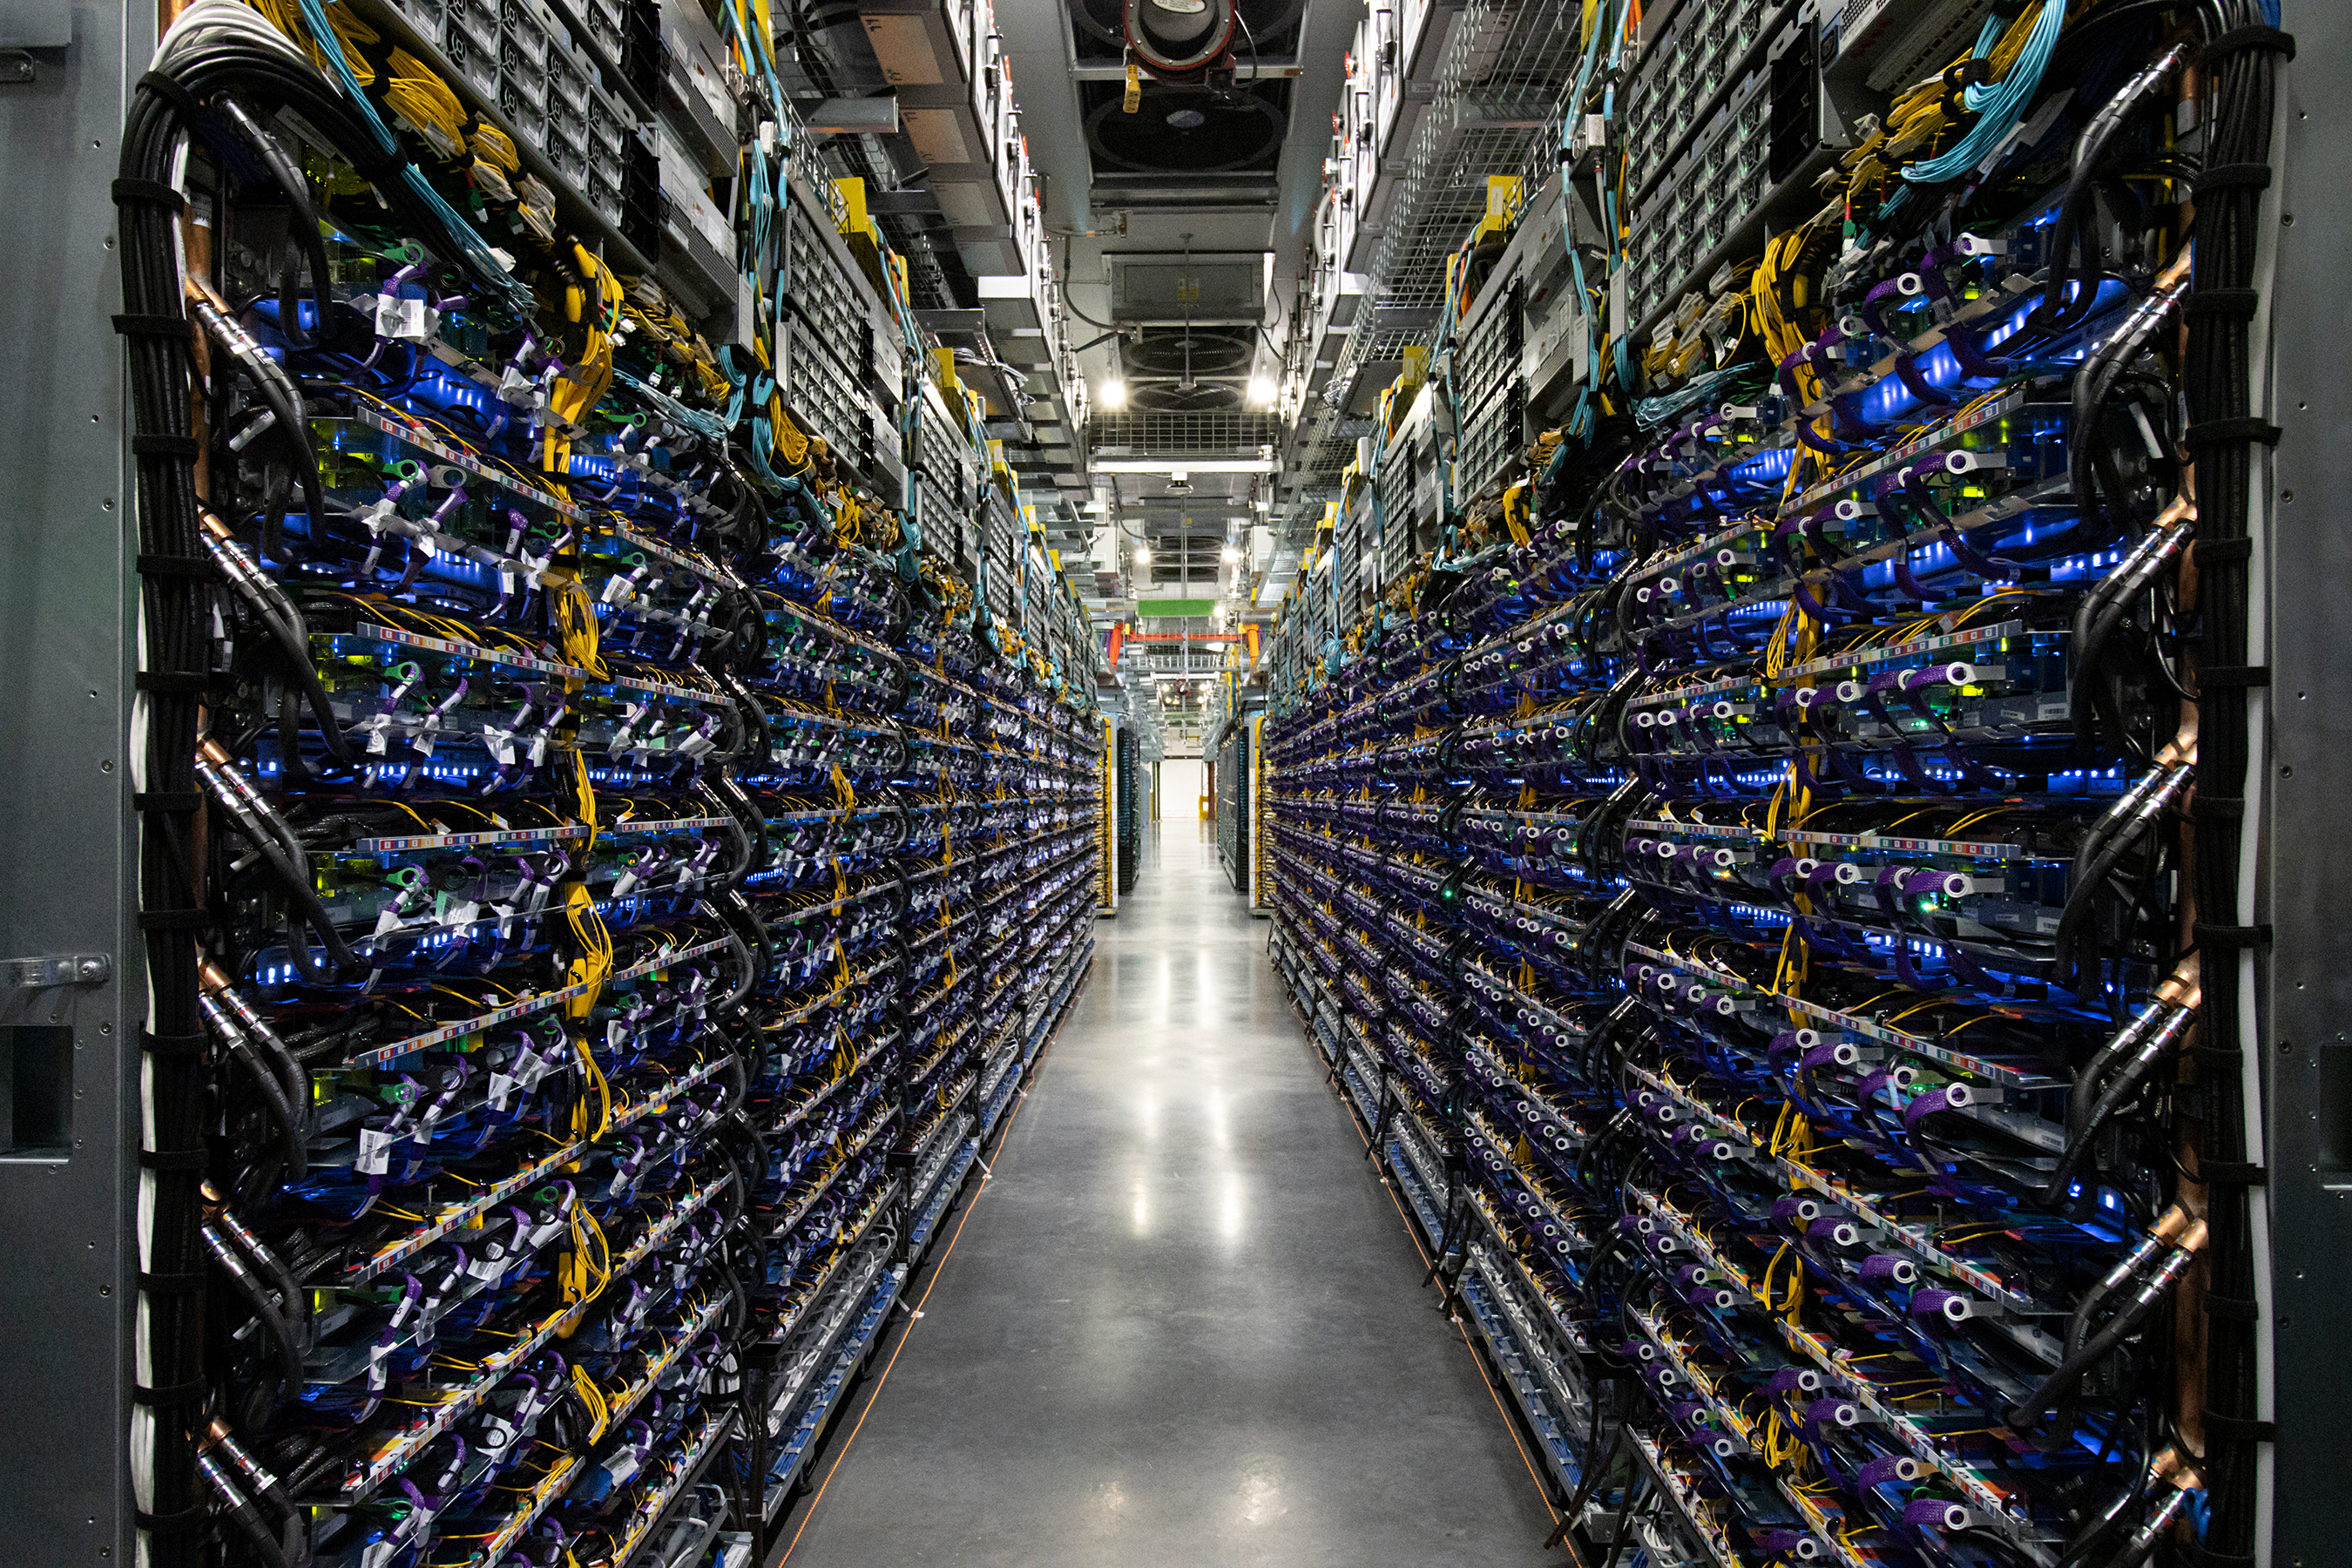
أعلنت Google Cloud يوم الاثنين (9 نوفمبر) عن نظامين جديدين من الجيل الثامن لوحدة معالجة الموتر (TPU) - TPU 8tx وTPU 8i Max - يهدفان إلى الحوسبة السرية وتطبيقات الذكاء الاصطناعي طويلة السياق على التوالي. تؤدي هذه الإضافات إلى رفع عدد أنظمة TPU التي قدمتها Google هذا العام إلى أربعة، وهي المرة الأولى منذ أكثر من عقد من تطوير السيليكون داخليًا والتي قامت الشركة بشحن هذا العدد منها في عام واحد، مما أدى إلى تصعيد تحديها لهيمنة Nvidia على سوق مسرعات الذكاء الاصطناعي. (الصورة: صورة ملف لمركز بيانات Google TPU، مقدمة من Google Research.)
يستهدف 8tx الحوسبة السرية المقترنة بمعالجات AMD
يستخدم TPU 8tx نفس قالب السيليكون الذي تستخدمه شريحة التدريب TPU 8t التي تم تقديمها في أبريل، والتي تم إعادة تجميعها للاستدلال الآمن والسري جنبًا إلى جنب مع التدريب على نطاق صغير، وإقرانها بمعالجات AMD EPYC من الجيل الخامس كمضيفين. ويتميز النظام بتشفير على مستوى الشريحة لحماية البيانات وأوزان النماذج أثناء المعالجة، ويستهدف الوكالات الحكومية والشركات في الصناعات الخاضعة للتنظيم. قالت Google إن 8tx يستخدم تقنية شبكة Boardfly الخاصة به لتوفير زمن وصول أقل بما يصل إلى مرتين من TPU 8t، مع عقوبة أداء تقترب من الصفر.
يحتوي 8i Max على شريحتين للتعامل مع نوافذ السياق الضخمة
يجمع جهاز TPU 8i Max بين شريحتي استدلال TPU 8i منخفضي زمن الاستجابة في حزمة واحدة، ومضاعفة كثافة الحوسبة، وذاكرة الوصول العشوائي الثابتة، وسعة الذاكرة ذات النطاق الترددي العالي وعرض النطاق الترددي مقارنة بـ 8i المستقل. وهو مصمم لتطبيقات الذكاء الاصطناعي التي تحتاج إلى نوافذ سياقية طويلة جدًا، مثل الصوت متعدد الساعات وقواعد التعليمات البرمجية الكبيرة وتدفقات الفيديو الطويلة، مع حالات الاستخدام بما في ذلك اكتشاف الأدوية والرياضيات والبرمجة. يجمع جهاز TPU 8i واحد بين 288 جيجابايت من الذاكرة ذات النطاق الترددي العالي و384 ميجابايت من ذاكرة الوصول العشوائي (SRAM) على الشريحة.
أربعة أنظمة في السنة حيث يصبح التخصص هو الإستراتيجية
طرحت Google جهاز TPU 8t للتدريب واسع النطاق وجهاز TPU 8i للاستدلال في الوقت الفعلي في Google Cloud Next في 22 أبريل 2026؛ يقدم الزوج ما يصل إلى 2.7 مرة من أداء التدريب للجيل السابق وأداء استدلالي أفضل بنسبة تصل إلى 80% لكل دولار. وقال أمين وحدات، الذي يقود أعمال الرقائق في جوجل، إن المنتجات الجديدة ليست تصميمات جديدة تمامًا من السيليكون، ولكنها إعادة تشكيل مصممة لتلبية طلبات العملاء، وأن المستقبل يكمن في التخصص. وقال مارك لومير، نائب رئيس الذكاء الاصطناعي والبنية التحتية للحوسبة في Google Cloud، إن الشركة تخطط لمواصلة توسيع نطاق الرقائق المتخصصة لتعكس التنوع المتزايد لأعباء عمل الذكاء الاصطناعي.
ما يقرب من 100 عميل. ويرى المحللون أن المبيعات سترتفع عشرة أضعاف خلال ثلاث سنوات
قالت Google إن ما يقرب من 100 عميل، بما في ذلك Oracle وAnthropic وOpenAI، يستخدمون تقنية TPU الخاصة بها، وتشير التقارير إلى أن تكلفة وحدات TPU أقل بنسبة 30٪ تقريبًا من وحدات معالجة الرسوميات Nvidia. وتتوقع بلومبرج إنتليجنس أن تنمو المبيعات المتعلقة بـ TPU، بما في ذلك البرامج والأجهزة، من حوالي 12 مليار دولار هذا العام إلى أكثر من 135 مليار دولار بحلول عام 2028. ومن المتوقع أن يتم شحن كلا النظامين الجديدين في العام المقبل. ولا يزال نقص الإمدادات ومعارضة مراكز البيانات يشكلان عائقاً أمام النمو.
💬 Comments
No comments yet. Be the first!