 N環球

中國安納智芯發布 AX100 類比晶片 單次解矩陣方程不到 100 奈秒
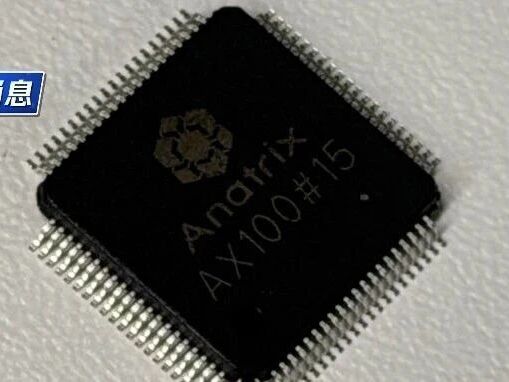
安納智芯稱 AX100 是世界首顆全集成一步求解矩陣方程的類比計算晶片,10 月已完成流片,單次求解不到 100 奈秒、功耗約 80 毫瓦,可用成熟製程生產。
中國模擬計算晶片公司安納智芯(Anatrix)11 月 15 日宣布,自主研發的 AX100 晶片已於 10 月完成流片。公司稱,這是世界首顆全集成一步求解矩陣方程的模擬計算晶片,測試顯示單次矩陣方程求解時間小於 100 奈秒,單次計算功耗約為 80 毫瓦,符合理論仿真與設計預期。消息由《科技日報》率先報導。
矩陣變電路 一次讀出答案
矩陣方程是人工智慧模型訓練、機器人動作控制和無線通訊訊號處理背後的核心數學問題。傳統數位晶片要靠一連串逐步運算求解,AX100 則把矩陣方程直接映射為電路,電路自行達到平衡後一次讀出結果,無需迭代。安納智芯行政總裁向銳表示,AX100 與 GPU 類數位晶片在架構和底層邏輯上完全不同,具備現代模擬計算的頂尖計算能力。
三個場景的測試數據
安納智芯在三個場景下測試了這款晶片。在人工智慧訓練中,以一個 293 萬參數的自編碼器模型和一個 272 萬參數的 Transformer 模型驗證,模型參數更新的計算成本分別降低 92% 和 56%。在具身智慧方面,測試顯示機器人的運動控制和路線規劃更快,有助機器人對環境變化作出更即時反應。在無線通訊方面,針對 128×128 規模的通道格拉姆矩陣,模擬計算晶片相比現有數位 ASIC 晶片與 GPU 的等效吞吐提升 20 至 207 倍,等效能效提升 27.6 至 61.3 倍。
源自北大研究 可用成熟製程生產
AX100 的技術源自北京大學人工智慧研究院孫仲團隊 2025 年 10 月發表於《自然・電子學》的研究。該團隊把模擬計算的精度從此前的百分之一量級提升到千萬分之一量級,單次矩陣方程求解比先進 GPU 快 3 個數量級、能效高 2 個數量級。論文發表僅一年,安納智芯便把這項技術從實驗室推向產線。公司表示,AX100 可以用成熟的晶片製造工藝生產,無需最先進製程。
需要留意的是,「世界首顆」的說法及上述測試數據均為安納智芯的公司說法,尚未經過獨立驗證;完成流片也不等於量產。晶片能否在大規模實際應用中保持同樣的精度與效率,仍有待進一步的公開測試與產業驗證。
💬 留言
暫時還沒有留言,來搶沙發!