 N環球

谷歌 AI Edge Gallery 加入離線語音識別與語音合成 手機無網也能即時對話
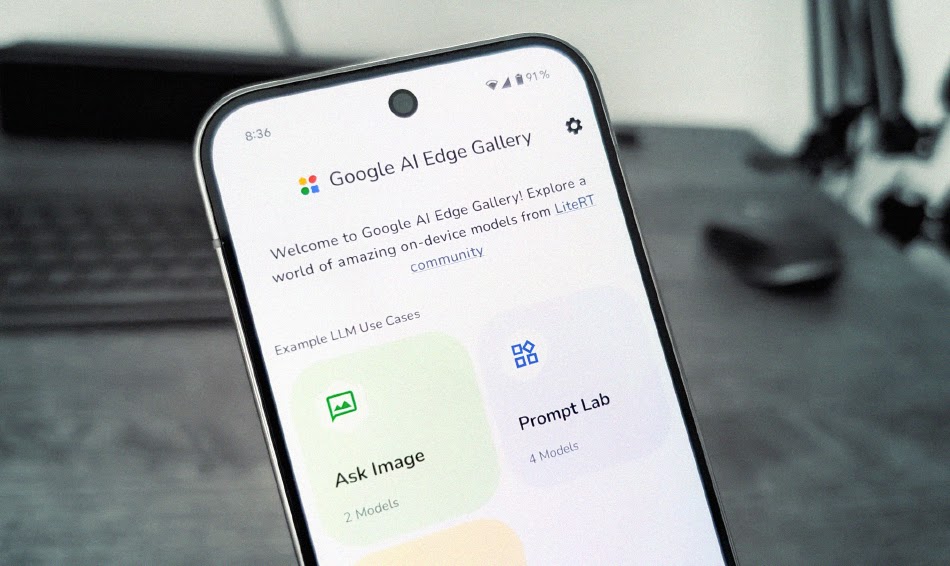
谷歌 11 月 10 日宣布,AI Edge Gallery 加入端側離線自動語音識別與語音合成,搭配 Gemini Nano、Gemma 4 等端側小模型,手機無需聯網即可即時轉錄語音、朗讀回覆。
谷歌 11 月 10 日宣布,在 AI Edge Gallery 加入端側(on-device)自動語音識別(ASR)與語音合成(TTS)功能,搭配 Gemini Nano、Gemma 4 等端側小型語言模型,手機無需聯網即可即時轉錄語音、朗讀回覆。谷歌表示,語音往往是手機與穿戴裝置上最自然的人機互動方式,而輕量語音模型的進步,已令準確的多語言語音識別與自然的語音合成可以在裝置上完整離線運行。
Android:ML Kit 支援 100 多種語言 開口僅約 100 毫秒
Android 方面,ML Kit 的新一代端側語音模型支援 100 多種語言轉錄,速度為即時語音的 10 倍,在 FLEURS 測試中字錯率為 8.0% 至 9.0%。語音合成採用少步驟擴散模型,約 100 毫秒即可開口,以 24 kHz 音質、最高 50 倍即時速度合成語音,提供 8 種聲音、21 個地區。兩個模型均整合於作業系統內,不增加應用程式安裝包大小,開發者亦無需自行管理模型下載,並可透過 NPU、TPU 硬件加速。
跨平台:開源權重模型 iOS、Windows、網頁都能用
跨平台方面,谷歌透過 MediaPipe Tasks 與 LiteRT 推出新的 .litertlm 模型包,包括 Parakeet-TDT 0.6B(語音識別)、PocketTTS 100M、Kokoro-82M 與 Phonon 31M(語音合成),支援 iOS、macOS、Windows、Linux 與網頁,可與端側小模型並行運行而不搶佔算力。Hugging Face LiteRT 社群另提供 Whisper、Qwen3-ASR 等開源模型供開發者選用。
展示應用:離線語言教師與語音聊天
谷歌同時展示兩個應用場景:XR Language Teacher 可在完全離線下,用相機辨識街景招牌或菜單、即時語音提問,並以使用者母語解說、以外語朗讀正確發音;AI Chat 則加入語音輸入與朗讀播放,支援逐句同步高亮。相關功能即日起可供體驗,AI Edge Gallery 應用已上架 Android 與 iOS,參考程式碼亦已開源。來源:Google Developers Blog,2026 年 11 月 10 日。
💬 留言
暫時還沒有留言,來搶沙發!