 N環球

英偉達 Vera Rubin 橫掃 MLPerf 訓練測試 智能體推理能效號稱十倍於上代
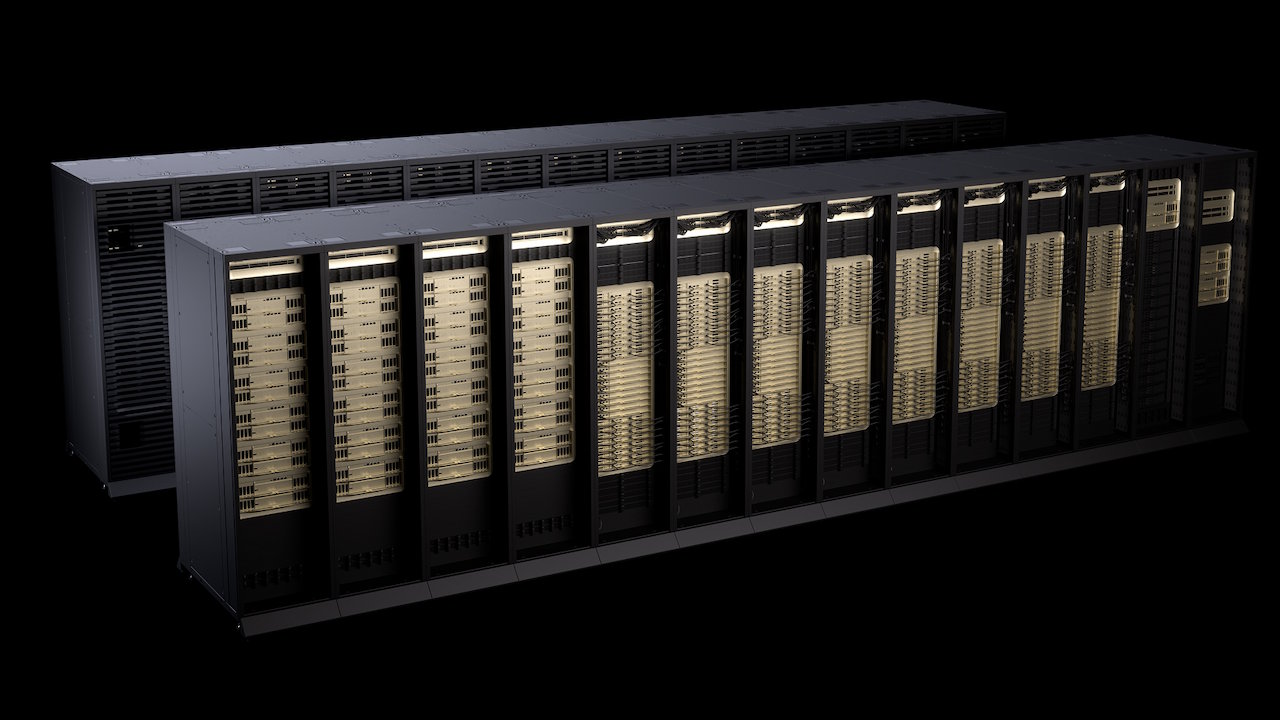
英偉達11月16日公布,Vera Rubin 平台在 MLPerf Training v6.1 全部測試中奪冠,首次提交的 MLPerf Endpoints 智能體推理成績更號稱每瓦吞吐量較上代 GB300 高出十倍以上;不過智能體端數字仍屬暫定,尚待 MLCommons 驗證。
英偉達11月16日在芝加哥超級計算大會SC26期間公布,Vera Rubin 平台在 MLPerf Training v6.1 全部測試項目中奪冠,成為本輪唯一在每個測試都有成績的平台;首次提交的 MLPerf Endpoints 智能體推理成績,暫定數字顯示每瓦吞吐量較上代 GB300 NVL72 高出十倍以上。成績由英偉達官方博客發布,MLCommons 同日公布本輪完整結果。
訓練測試:全數奪冠,擴展效率約 97%
MLPerf Training 衡量系統把各類人工智能模型訓練到目標準確率的速度,涵蓋大語言模型、圖像生成、推薦系統與訓練後強化學習。本輪 Vera Rubin NVL72 單顆圖形處理器的表現較高度優化的 GB300 NVL72 最高高出一倍。在 DeepSeek-V3 測試中,Vera Rubin 由 256 顆擴展至 1,024 顆圖形處理器,效率維持約 97%,訓練時間由 16 分鐘縮短至約 4 分鐘。英偉達亦以 GB300 系統跑出 10,240 顆圖形處理器的測試,是本輪最大規模。
智能體推理:十倍數字仍待驗證
在首次提交的 MLPerf Endpoints 測試中,英偉達以開源智能體模型 Kimi K3 作暫定成績:32 個加速器的 Vera Rubin NVL72 系統吞吐量為每秒 41,414.2 個詞元、功耗 100.89 千瓦;對比 48 個加速器的 GB300 NVL72 每秒 2,210.4 個詞元、功耗 60 千瓦。英偉達在官方博客中明確標註,Vera Rubin 的智能體端數字屬暫定、尚待 MLCommons 協會驗證,經同行評審後可能有變;GB300 的數字則已獲驗證。讀者應把十倍能效理解為廠商公布的暫定成績,而非已核實的最終結果。
本輪規模與雲端廠商成績
MLCommons 表示,Training v6.1 共有 24 個機構提交、153 套系統、250 項成績,新增推薦系統 DLRMv4-HSTU 與大規模語言模型訓練後測試 Qwen3.5-397B 兩項;參賽硬件除英偉達、AMD 外,首次出現 Rubin 世代圖形處理器與 Google TPUv7(Ironwood)。雲端廠商 CoreWeave 同日宣布,成為首家提交多機架 Vera Rubin 成績的雲服務商:以 256 顆 Rubin 圖形處理器在 17.65 分鐘內完成 6,710 億參數 DeepSeek-V3 訓練,較自家 GB200 同規模成績快 2.7 倍;單機架 72 顆 Rubin 則在 7.16 分鐘完成 Llama 3.1 8B,較 GB200 快 1.9 倍。CoreWeave 亦註明,其倍數由已公布成績自行推算,未經 MLCommons 驗證。
背景:財報前夕的關鍵一周
這是英偉達在 SC26 的第二波重磅發布,本輪早前已推出科研智能體工具 Nemotron for Science。英偉達將於 11 月 17 日星期二公布季度業績,是創辦人黃仁勳 11 月 12 日辭任行政總裁、財務總監科萊特·克雷斯出任臨時行政總裁後的首份業績;市場關注新平台的出貨進度與需求口徑,MLPerf 成績被視為公司在財報前展示技術領先地位的一步。
💬 留言
暫時還沒有留言,來搶沙發!