 N環球

超微聯手IBM與輝達推KV快取儲存 長文本AI推論首字回應快56倍
超微今日宣布與IBM、輝達合作推出KV快取儲存方案,把AI推論中可重複使用的上下文從GPU記憶體搬到共享儲存;聯合測試顯示,13萬字元提示的首字回應時間最快可提升56倍。
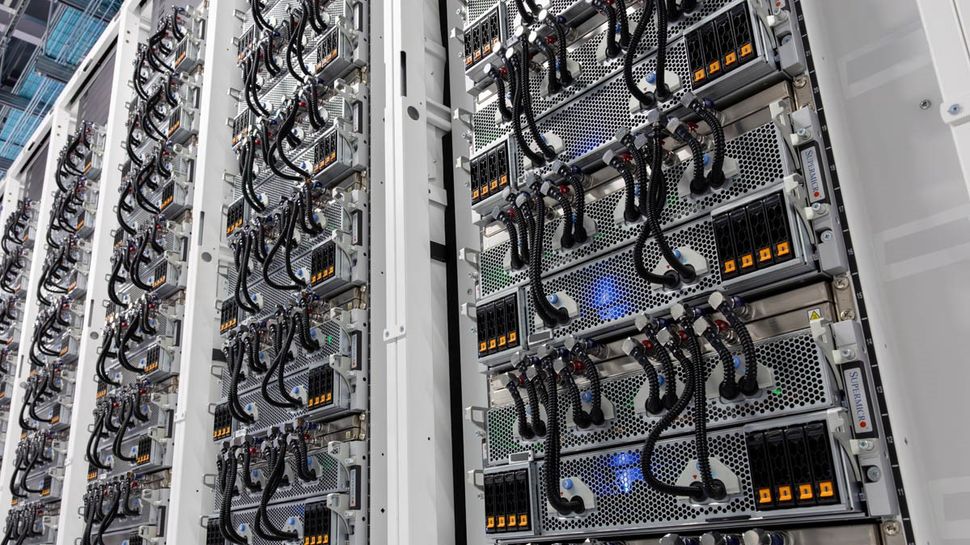
美國伺服器大廠超微(Supermicro)今日(11月5日)宣布,與IBM及輝達(NVIDIA)合作推出KV快取(KV cache)儲存方案,把AI推論中可重複使用的上下文從GPU記憶體搬到共享儲存。聯合測試顯示,在13萬字元(token)的提示下,首字回應時間最快可提升56倍。(圖片:AI數據中心資料圖片。)
把推論上下文搬出GPU記憶體
這套方案整合超微Petascale全快閃儲存伺服器(採用AMD EPYC 9005系列處理器)、IBM Storage Scale軟體、輝達Dynamo推論框架,以及輝達Spectrum-X乙太網路。IBM Storage Scale的糾刪碼版本(Erasure Coding Edition)提供輝達記憶體層級中的共享G4儲存層,讓多台GPU伺服器共用同一份推論上下文,不必每張卡各自重算。
13萬字元提示 重算32秒變0.57秒
根據IBM紅皮書(Redbooks)參考架構的量測,13萬字元提示若由GPU重新計算需32.14秒,改用儲存端快取只需0.57秒。聯合測試以一台配備4張輝達RTX PRO 6000 GPU的超微客戶端節點,連接8節點Petascale儲存叢集完成,軟體堆疊包括Dynamo 0.9.0以上版本、vLLM 0.14.1,測試模型為openai/gpt-oss-120b。
超微表示,方案針對長上下文推論與代理式(agentic)工作負載設計,隨著提示愈來愈長、對話歷史愈來愈多,快取能避免重複計算、降低延遲與成本。需要留意的是,56倍是特定測試條件下的首字回應時間對比,並非所有提示長度或模型都可達到同一幅度。
(來源:超微/PR Newswire、Unite.AI,2026年11月5日。)
💬 留言
暫時還沒有留言,來搶沙發!