 N環球

IBM পরবর্তী প্রজন্মের কোয়ান্টাম চিপ Nighthawk r3: 520 qubits উন্মোচন করেছে, যা 2027 সালে 1,000-এর বেশি লক্ষ্য করে
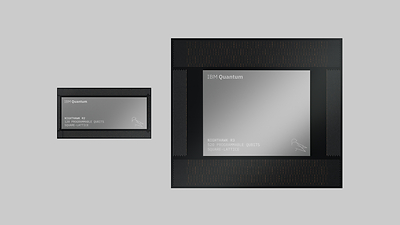
IBM ঘোষণা করেছে তার পরবর্তী প্রজন্মের কোয়ান্টাম প্রসেসর, Nighthawk r3, 520টি প্রোগ্রামেবল কিউবিট জুড়ে 10,000 কোয়ান্টাম অপারেশন নির্ভুলভাবে চালানোর জন্য ডিজাইন করা হয়েছে; 2027 সালে এটি একটি 1,040-কিউবিট সিস্টেমে দুটি r3 প্রসেসর লিঙ্ক করার পরিকল্পনা করেছে।
IBM মঙ্গলবার (11 নভেম্বর) ঘোষণা করেছে তার পরবর্তী প্রজন্মের কোয়ান্টাম প্রসেসর, Nighthawk r3, বৃহত্তর, আরও জটিল গণনার জন্য 520টি প্রোগ্রামেবল কিউবিট জুড়ে 10,000 কোয়ান্টাম অপারেশন নির্ভুলভাবে চালানোর জন্য ডিজাইন করা হয়েছে; 2027 সালে এটি একটি একক 1,040-কিউবিট সিস্টেমে দুটি r3 প্রসেসরকে লিঙ্ক করার পরিকল্পনা করেছে, ত্রুটি-সহনশীল কোয়ান্টাম কম্পিউটিং এর দিকে অগ্রসর হবে।
r3: 1,000 কিউবিট অতিক্রম করার জন্য ডিজাইন করা হয়েছে
r3 r2 এর উচ্চ-গতির আর্কিটেকচারকে প্রসারিত করে, যা 520টি প্রোগ্রামেবল কিউবিট এবং 2,034টি মোট ফিজিক্যাল কিউবিটকে সমর্থন করার জন্য ডিজাইন করা হয়েছে, 10টি চিপ-টু-চিপ ইন্টারকানেক্ট প্রবর্তন করার সময় r2-এর স্কয়ার-লেটিস কানেক্টিভিটি এবং দ্রুত ক্রিয়াকলাপগুলিকে টিকিয়ে রাখা হয়েছে, যাকে বলা হয় l-cosler-এর সিস্টেমে কানেক্টর। IBM বলেছে যে এটি দুটি সমালোচনামূলক মডুলার প্রযুক্তি প্রদর্শন করেছে: এই বছর এটি দুটি Nighthawk r1 প্রসেসরকে চারটি l-কাপলার ব্যবহার করে সংযুক্ত করেছে, 99.3 শতাংশ কোয়ান্টাম স্টেট ট্রান্সফার ফিডেলিটি (99.9 শতাংশ লক্ষ্যের বিপরীতে) অর্জন করেছে এবং দুটি ক্রায়োজেনিক মডিউলকে সংযুক্ত করেছে, একটি একক সময়ের মধ্যে পাঁচ দিনের কম তাপমাত্রায় পৌঁছানোর জন্য প্রথমবারের মতো শীতল সিস্টেমে পৌঁছেছে। 15 মিলিকেলভিন।
উৎপাদনে r2: 34 বিলিয়ন সার্কিট, 19x পর্যন্ত গতি
বর্তমান Nighthawk r2, সেপ্টেম্বরে প্রবর্তিত, 120 কিউবিট রয়েছে, প্রতি সেকেন্ডে 100,000 নমুনা সরবরাহ করে এবং 7,500 এরও বেশি কোয়ান্টাম অপারেশন সহ সঠিক গণনা সমর্থন করে। E.ON, Algorithmiq এবং Q-CTRL সহ ক্লায়েন্ট এবং অংশীদাররা r2 তে 34 বিলিয়নেরও বেশি সার্কিট চালায়, 19x পর্যন্ত গতির রিপোর্ট করে: E.ON এনার্জি গ্রিড অপ্টিমাইজেশনের জন্য কোয়ান্টাম মেশিন লার্নিংয়ে 15x গতির রিপোর্ট করেছে; ওক রিজ ন্যাশনাল ল্যাবরেটরির সাথে একটি আইবিএম পরীক্ষা বাস্তব চৌম্বকীয় পদার্থের অনুকরণ করে 12 গুণ দ্রুত গতিতে চলে, যার ফলাফল নিউট্রন বিক্ষিপ্ত পরীক্ষার সাথে সামঞ্জস্যপূর্ণ ছিল; এবং একটি ভিন্নধর্মী কোয়ান্টাম উপাদানের অনুকরণে একটি অ্যালগোরিদমিক পরীক্ষা হেরনের তুলনায় 8 গুণ দ্রুত গতিতে চলে, যখন এটিকে অগ্রণী টেনসর-নেটওয়ার্ক পদ্ধতির সাথে ক্লাসিকভাবে অনুকরণ করতে আনুমানিক 240 গুণ বেশি মেমরির প্রয়োজন হবে।
কোয়ান্টাম ক্লাসিক্যাল কম্পিউটিং পূরণ করে
IBM একটি একক পরিচালিত পরিবেশে কোয়ান্টাম কম্পিউটিং-এর সাথে উচ্চ-পারফরম্যান্স ক্লাসিক্যাল কম্পিউটিংকে একত্রিত করছে, IBM কোয়ান্টাম প্ল্যাটফর্ম: IBM এবং RIKEN বিজ্ঞানীরা তাদের নমুনা-ভিত্তিক কোয়ান্টাম ডায়াগোনালাইজেশন ওয়ার্কফ্লো মোটামুটি 5 গুণ দ্রুত সম্পন্ন করেছে যখন 100 গুণ বেশি কম্পিউটেশন এবং RIKEN 100 গুণ বেশি কম্পিউটিং এবং প্রক্রিয়াকরণ করেছে। জৈবিকভাবে প্রাসঙ্গিক কাঠামোর মডেলিংয়ের জন্য নমুনা, 33 গুণ দ্রুত। IBM সম্প্রতি ওক রিজ ন্যাশনাল ল্যাবরেটরি এবং AMD এর সাথে কোয়ান্টাম ত্রুটি সংশোধনের জন্য একটি সহ-ডিজাইন প্ল্যাটফর্ম চালু করেছে, শারীরিকভাবে নাইটহককে ORNL-এর Umbra সুপার কম্পিউটারের সাথে, AMD Instinct MI355X GPUs এবং 5th Gen AMD EPYC CPUs দ্বারা চালিত করে। IBM রিসার্চের ডিরেক্টর জে গাম্বেটা বলেন, "উপযোগী কোয়ান্টাম কম্পিউটিং ফলাফল নির্ভুলতা এবং গতির সাথে সরবরাহ করা যায় কিনা তার উপর নির্ভর করে, উভয়ই মৌলিক।"
(চিত্র: IBM। নাইটহক r3 (বাম) এবং r2 (ডান) প্রসেসরের রেন্ডার।)
💬 Comments
No comments yet. Be the first!