 N環球
Nvidia lanza modelos abiertos Nemotron 3.5 para agentes empresariales y PC locales con IA
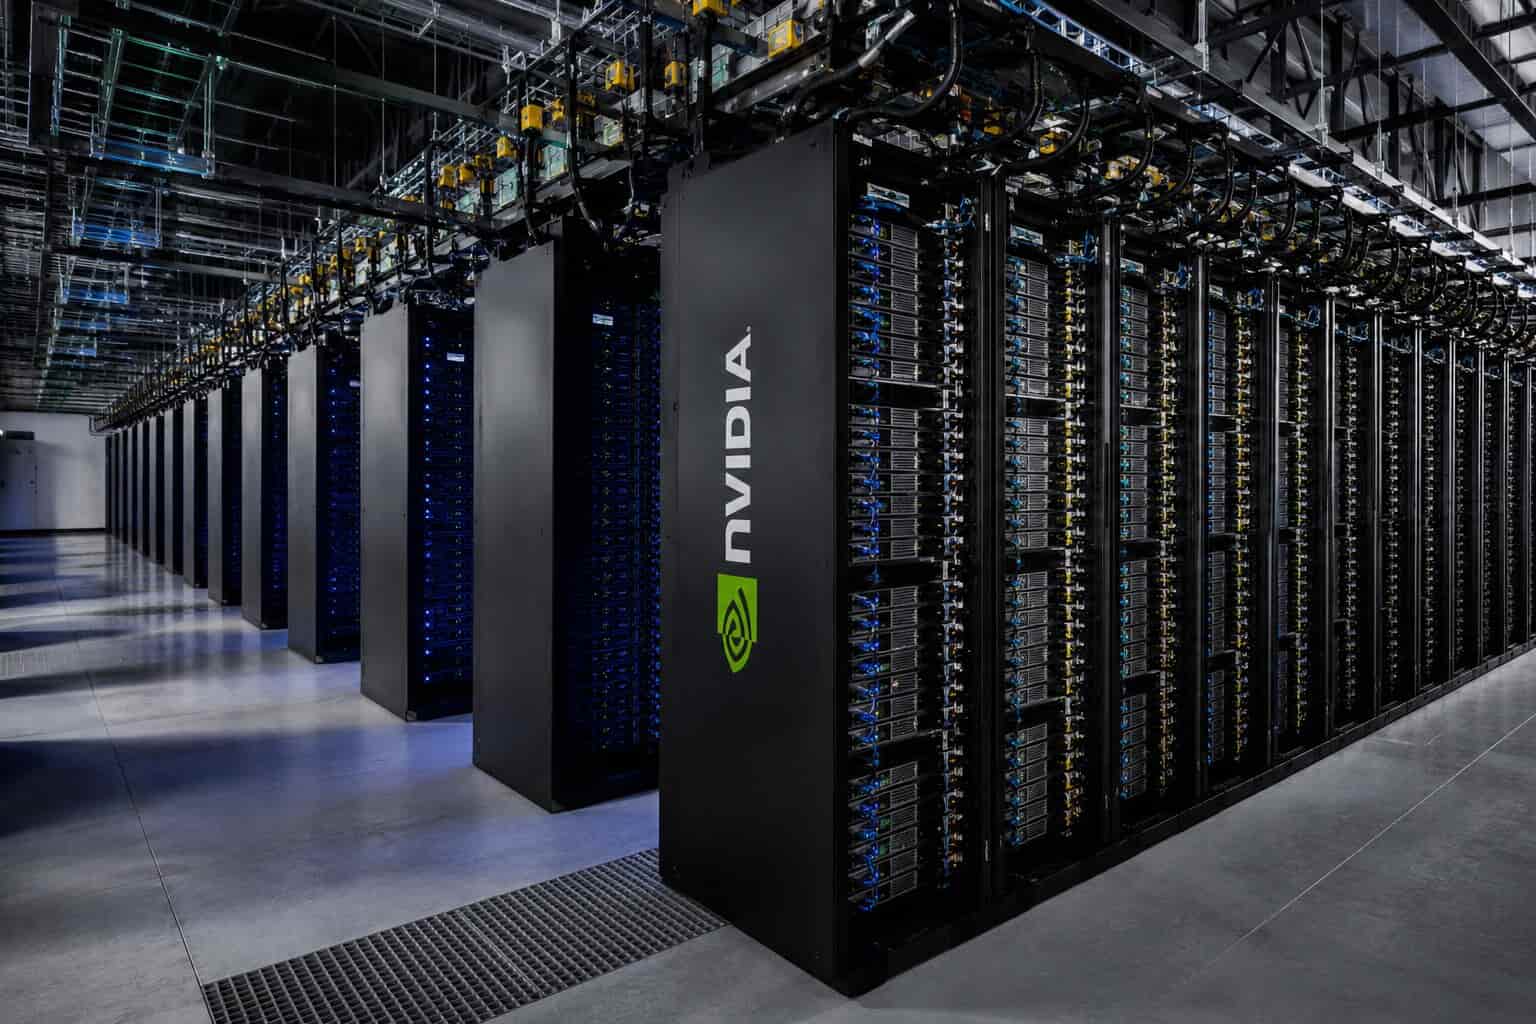
El nuevo Nemotron 3.5 Super VL de 120 mil millones de parámetros de Nvidia y dos modelos Bolt livianos se entregan con pesos abiertos, conjuntos de datos y recetas de capacitación, dirigidos a agentes siempre activos en la empresa y en PC locales con IA.
Por qué es importante
Nvidia está sacando el campo de batalla de los agentes de IA de la nube hacia la empresa y la computadora personal: toda la familia Nemotron 3.5 viene con pesos abiertos, conjuntos de datos y recetas de capacitación, para que las empresas puedan ajustar e implementar en su propia infraestructura con sus propios datos, un paso clave a medida que las empresas exigen soberanía y privacidad de los datos.
Informe completo
El 15 de octubre, Nvidia lanzó la familia Nemotron 3.5 de modelos abiertos creados para agentes siempre activos y computación de vanguardia. El buque insignia, Nemotron 3.5 Super VL, incluye 120 mil millones de parámetros en una arquitectura mixta de expertos que activa solo alrededor de 12 mil millones de parámetros por token. Nvidia dice que iguala la precisión de su modelo de razonamiento más amplio, Nemotron 3 Ultra, en tareas de agente de seguimiento de instrucciones y uso de herramientas.
La compañía también afirma que Super VL completa tareas de agente post-entrenadas más rápido que los modelos comparables de Anthropic y OpenAI (Opus 5, GPT 6.1 Sol) y encabeza su clase en la clasificación de Análisis Artificial con hasta 5 veces el rendimiento, el tipo de afirmación que acompaña a cada lanzamiento de proveedor y necesita verificación independiente. Nvidia enumera los primeros usuarios empresariales, incluidos Skydance, EY, Ramp, Crowdstrike, Perplexity y Salesforce; el modelo está disponible en Hugging Face, OpenRouter, ModelScope y NVIDIA NIM.
Dos modelos Bolt livianos apuntan a la computación local: Nemotron 3.5 Bolt 74B-A9B utiliza cuantificación nativa de 2 bits para caber en 24 GB de memoria y ejecuta tareas de agente (razonamiento de varios pasos, llamadas de herramientas, navegación web) localmente en nuevas PC con IA con chips Nvidia RTX Spark y estaciones de trabajo DGX Spark, que ahora se distribuyen a través de socios como Microsoft y Dell. El Bolt E4B (4 GB), más pequeño, dirigido a asistentes de voz y agentes conversacionales, llegará a finales de este mes.
El vicepresidente de Software y Modelos Abiertos de Nvidia, Kari Briski, dijo: "Cualquier organización que quiera ejecutar agentes en la infraestructura de Nvidia ahora tiene un modelo abierto y optimizado para su nivel sin tener que elegir entre capacidad y capacidad de implementación".
💬 Comments
No comments yet. Be the first!