 N環球
DeepSeek rend open source son framework d'inférence DeepInfer, compatible avec les puces Nvidia et Huawei Ascend
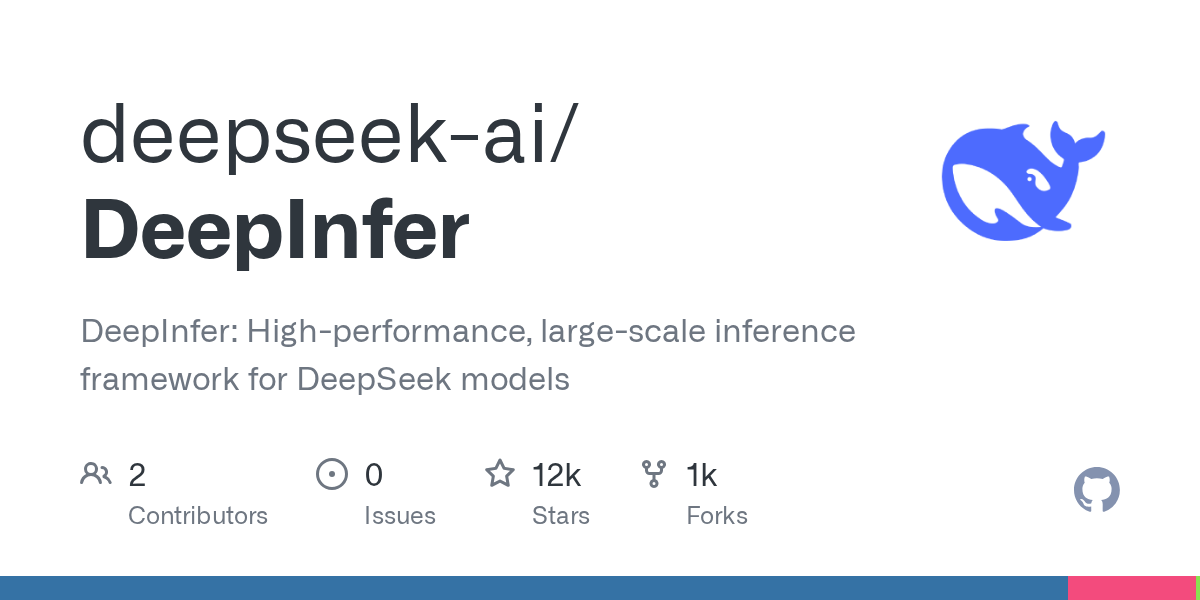
DeepSeek a annoncé la mise en open source de DeepInfer, le framework d'inférence haute performance qui alimente ses services de production à grande échelle, sous licence Apache 2.0. La première version prend en charge DeepSeek-V4.1-Flash sur GPU Nvidia SM100 et NPU Huawei Ascend 950.
Pourquoi c’est important
Le laboratoire chinois d'IA DeepSeek a annoncé sur son compte X officiel (@deepseek_ai, un fil de quatre messages se terminant par « Open models. Open kernels. Open inference. ») la mise en open source complète de DeepInfer, le framework d'inférence qui alimente ses services de production à grande échelle. Le code est disponible sur GitHub à l'adresse github.com/deepseek-ai/DeepInfer sous licence Apache 2.0, autorisant l'auto-hébergement commercial. Le dépôt a rapidement dépassé les 11 000 étoiles.
Lire l’article
DeepSeek décrit DeepInfer comme « le framework d'inférence haute performance qui alimente les services de production à grande échelle de DeepSeek ». La première version ne prend en charge qu'un seul modèle, DeepSeek-V4.1-Flash, sur deux types de matériel de centres de données : les GPU Nvidia SM100 (CUDA 13) et les NPU Huawei Ascend 950 (CANN 9.2).
Sur le plan technique, il inclut des opérateurs maison (FlashMLA, DeepGEMM, DeepEP, TileKernels, DeepSelect, opérateurs TileLang), le parallélisme d'experts MoE avec équilibrage de charge EPLB, le décodage spéculatif DSpark (longueur de brouillon par défaut de 5), l'ordonnancement asynchrone, l'inférence invariante par lot et l'échantillonnage déterministe (Nvidia uniquement), ainsi que les sorties structurées (regex / schéma JSON / EBNF). Le README indique qu'il a été « à l'origine construit principalement sur vLLM, avec une inspiration supplémentaire de SGLang et TensorRT-LLM ».
Cette version exclut le système de cache KV, le découplage prefill/decode et l'équilibrage de charge inter-réplicas ; les benchmarks ont été mesurés sur 4 GPU SM100 (prefill) et 64 (decode). DeepSeek a également publié deepseek-recipe, le composant de tokenisation/encodage correspondant à son API officielle.
Contexte : selon la presse, DeepSeek avait déclaré en avril 2025 ne pas prévoir d'ouvrir tout son moteur d'inférence, d'où un revirement ; l'annonce intervient au lendemain de l'ordre du gouvernement fédéral américain interdisant DeepSeek aux agences fédérales. DeepSeek affirme qu'un seul cluster V4.1-Flash sert 155 billions de tokens par jour (non vérifié de façon indépendante).
💬 Commentaires
Aucun commentaire. Soyez le premier !