 N環球
Nvidia lance les modèles ouverts Nemotron 3.5 pour les agents d'entreprise et les PC IA locaux
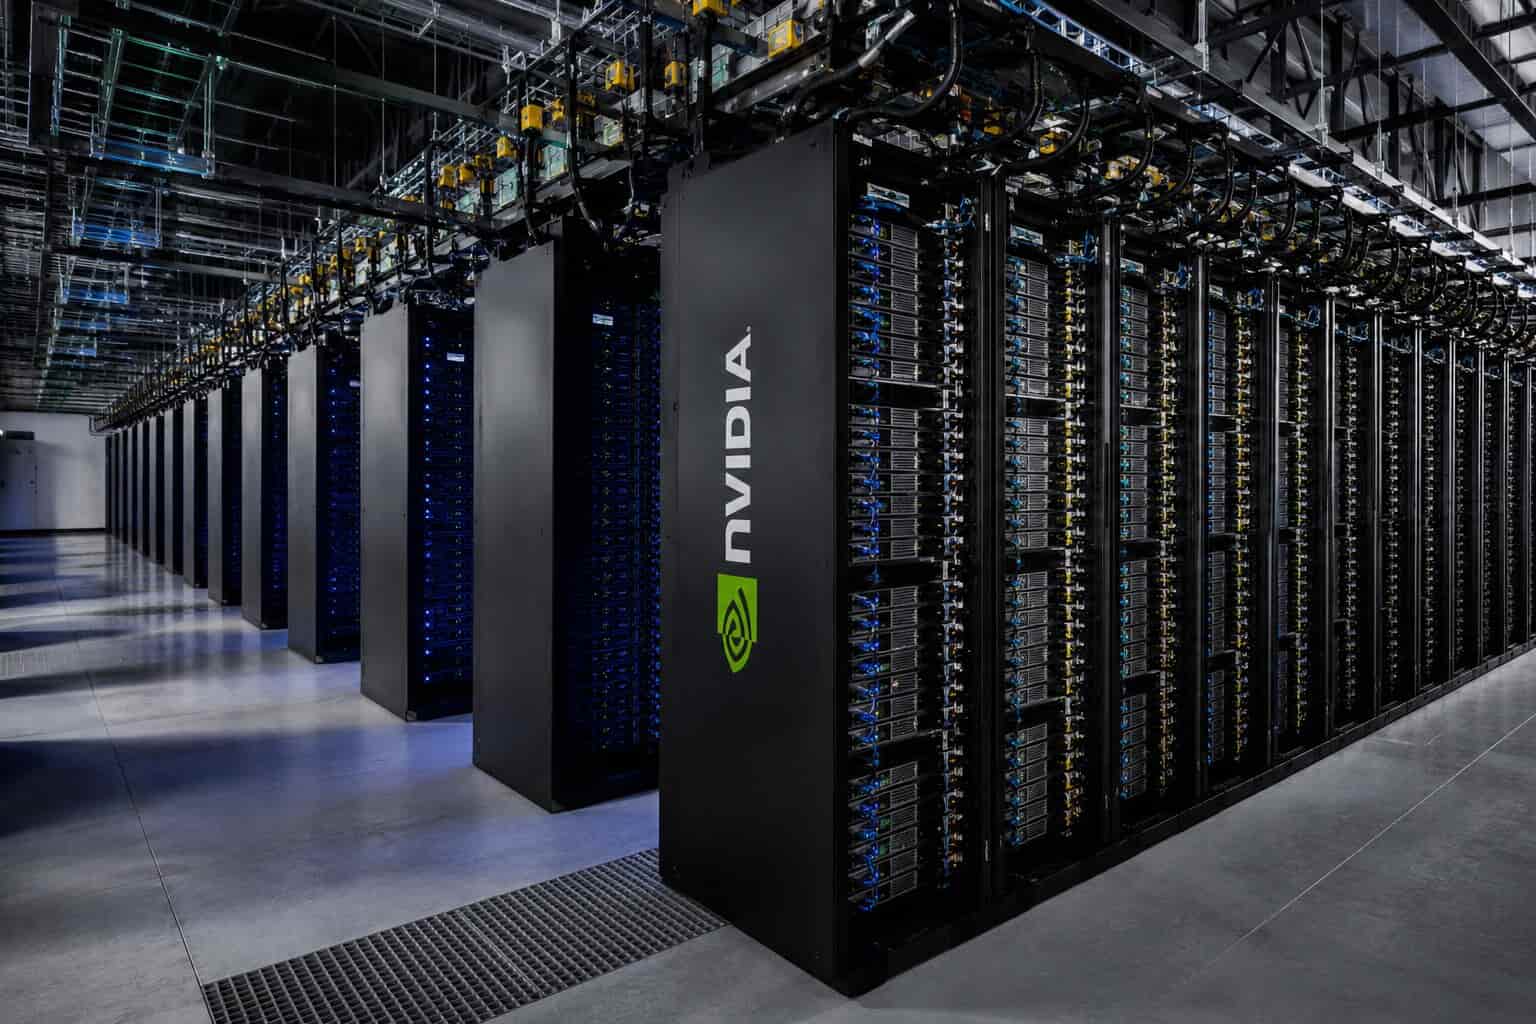
Le nouveau Nemotron 3.5 Super VL de 120 milliards de paramètres et deux modèles Bolt légers sont livrés avec poids ouverts, jeux de données et recettes d'entraînement, visant les agents toujours actifs en entreprise et sur les PC IA locaux.
Pourquoi c'est important
Nvidia déplace le champ de bataille des agents IA du cloud vers l'entreprise et l'ordinateur personnel : toute la famille Nemotron 3.5 est livrée avec poids ouverts, jeux de données et recettes d'entraînement, permettant aux entreprises de régler et déployer les modèles sur leur propre infrastructure avec leurs propres données — une étape clé face aux exigences de souveraineté et de confidentialité des données.
Lire l'article
Le 15 octobre, Nvidia a lancé la famille de modèles à poids ouverts Nemotron 3.5, conçue pour les agents toujours actifs et l'informatique de périphérie. Le modèle phare, Nemotron 3.5 Super VL, compte 120 milliards de paramètres dans une architecture de mélange d'experts qui n'active qu'environ 12 milliards de paramètres par jeton. Selon Nvidia, il égale la précision de son grand modèle de raisonnement Nemotron 3 Ultra sur le suivi d'instructions et l'utilisation d'outils.
Nvidia affirme aussi que Super VL exécute plus vite les tâches d'agents sur mesure que les modèles comparables d'Anthropic et d'OpenAI (Opus 5, GPT 6.1 Sol) et domine sa catégorie sur le classement Artificial Analysis avec un débit jusqu'à 5 fois supérieur — une affirmation typique des lancements de fabricants, à vérifier de façon indépendante. Nvidia cite parmi les premiers utilisateurs Skydance, EY, Ramp, Crowdstrike, Perplexity et Salesforce ; le modèle est disponible sur Hugging Face, OpenRouter, ModelScope et NVIDIA NIM.
Deux modèles Bolt légers visent l'informatique locale : le Nemotron 3.5 Bolt 74B-A9B utilise une quantification native 2 bits pour tenir en 24 Go de mémoire et exécute les tâches d'agents (raisonnement multi-étapes, appels d'outils, navigation web) localement sur les nouveaux PC IA à puce Nvidia RTX Spark et les stations DGX Spark, commercialisés via Microsoft et Dell. Le plus petit Bolt E4B (4 Go), destiné aux assistants vocaux et conversationnels, suivra plus tard ce mois-ci.
Kari Briski, vice-présidente des modèles ouverts et des logiciels chez Nvidia, a déclaré : « Toute organisation qui souhaite exécuter des agents sur l'infrastructure Nvidia dispose désormais d'un modèle ouvert et optimisé pour son niveau, sans avoir à choisir entre capacité et déployabilité. »
💬 Commentaires
Aucun commentaire. Soyez le premier !