 N環球

Supermicro, IBM et Nvidia lancent un stockage de cache KV ; premier jeton jusqu’à 56 fois plus rapide pour l’IA à long contexte
Supermicro a annoncé le 5 novembre une solution de stockage de cache KV avec IBM et Nvidia, qui déplace le contexte réutilisable de l’inférence IA de la mémoire GPU vers un stockage partagé ; les tests conjoints montrent un délai avant le premier jeton jusqu’à 56 fois plus court sur une invite de 130 000 jetons.
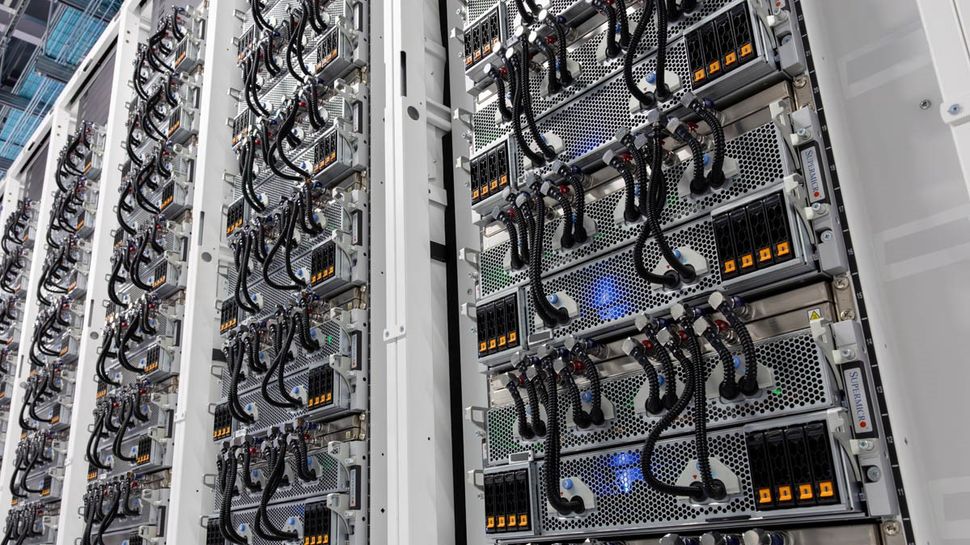
Le fabricant américain de serveurs Supermicro a annoncé mercredi (5 novembre) le lancement d’une solution de stockage de cache KV (key-value) avec IBM et Nvidia, qui déplace le contexte réutilisable de l’inférence IA de la mémoire des GPU vers un stockage partagé. Lors des tests conjoints, le délai avant le premier jeton sur une invite de 130 000 jetons a été jusqu’à 56 fois plus court. (Photo : image d’archive d’un centre de données d’IA.)
Sortir le contexte d’inférence de la mémoire GPU
La solution combine des serveurs de stockage tout-flash Petascale de Supermicro, équipés de processeurs AMD EPYC série 9005, le logiciel IBM Storage Scale, le cadre d’inférence Dynamo de Nvidia et le réseau Ethernet Spectrum-X de Nvidia. L’édition à codage par effacement (Erasure Coding Edition) d’IBM Storage Scale fournit le niveau de stockage partagé G4 dans la hiérarchie mémoire de Nvidia, ce qui permet à plusieurs serveurs GPU de partager le même contexte d’inférence au lieu de le recalculer sur chaque carte.
Invite de 130 000 jetons : 32 secondes de recalcul ramenées à 0,57 seconde
Selon les mesures d’une architecture de référence IBM Redbooks, le recalcul par GPU sur une invite de 130 000 jetons prenait 32,14 secondes, contre 0,570 seconde avec le cache adossé au stockage. Les tests conjoints ont utilisé un nœud client GPU Supermicro doté de quatre GPU Nvidia RTX PRO 6000, relié à un cluster de stockage Petascale de huit nœuds, avec Dynamo v0.9.0+, vLLM v0.14.1 et le modèle openai/gpt-oss-120b.
Supermicro indique que l’offre vise l’inférence à long contexte et les charges de travail agentiques, où la mise en cache évite les calculs répétés à mesure que les invites et les historiques de conversation s’allongent, réduisant latence et coûts. Le facteur 56 est une comparaison du délai avant le premier jeton dans des conditions de test précises ; toutes les longueurs d’invite ou tous les modèles n’atteindront pas le même gain.
(Sources : Supermicro / PR Newswire, Unite.AI, 5 novembre 2026.)
💬 Commentaires
Aucun commentaire. Soyez le premier !