 N環球

NVIDIA が Vera CPU ベンチマークをリリース、x86 の 2 倍のエージェント速度を主張
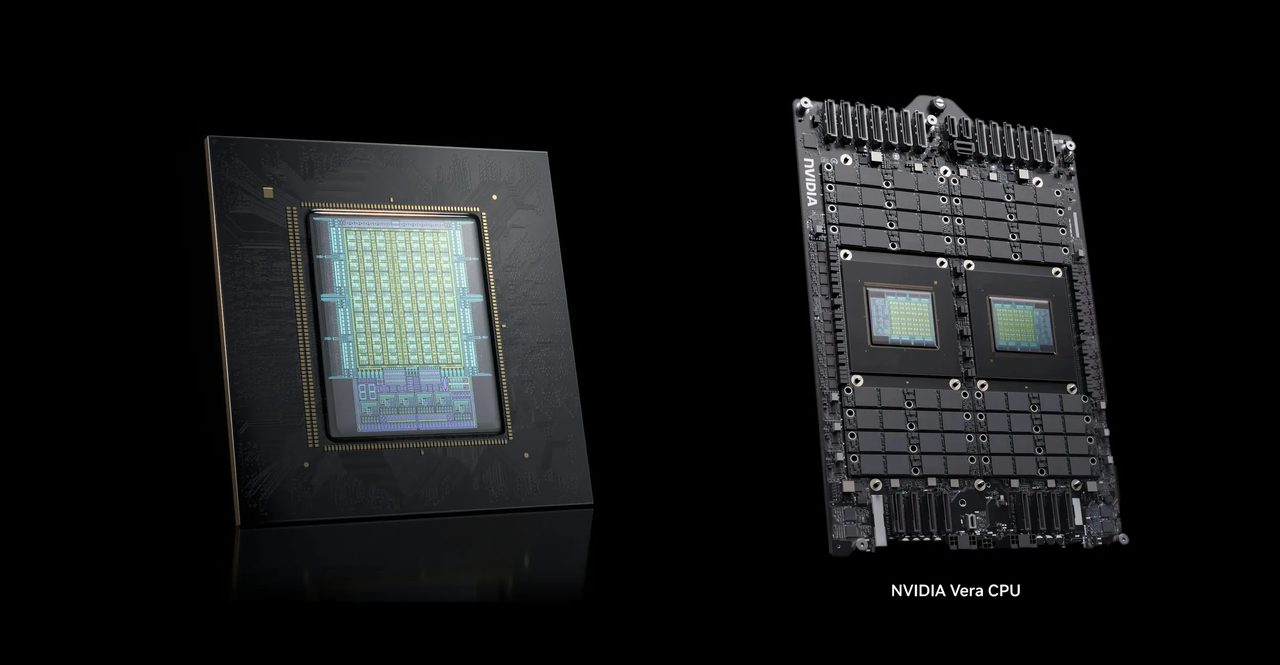
NVIDIA は 11 月 5 日、Vera CPU のテスト結果を発表し、100 メガワットのデータセンター比較で最もエネルギー効率の高い x86 プロセッサの 2 倍のエージェント実行速度を実現し、最速の x86 チップよりもワット当たりのエージェント数が 1.6 倍多いと発表しました。
NVIDIA は 11 月 5 日、エージェント AI ワークロード向けに設計されたプロセッサである Vera CPU の新しいベンチマーク結果を発表しました。同社によると、100メガワットのデータセンターとの比較では、Veraは最もエネルギー効率の高いx86プロセッサの2倍のエージェント実行速度を実現し、最速のx86プロセッサと比べてワット当たりの同時実行エージェント数が1.6倍になったという。
初期の顧客テスト: Perplexity レポートが約 1.5 倍高速化
NVIDIA は、数人の初期ユーザーからのテスト結果を引用しました。 Perplexity によれば、Vera は実稼働スタイルのテストで現在の実稼働リファレンスよりも約 1.5 倍速くコンピュータ スタイルのワークフローを実行し、最大 1.9 倍速く同時サンドボックスを開始し、次期実稼働システムに Vera を導入する予定であると述べています。 DeepInfra のベアメタル オーケストレーション ステップは、Vera では 29 ミリ秒でしたが、AMD Zen 5 では 35 ミリ秒、Intel Granite Rapids では 51 ミリ秒、Sapphire Rapids では 64 ミリ秒でした。
Daytona の報告によると、Vera は 1,000 のサンドボックスを 10.8 秒で準備したのに対し、AMD の EPYC 9575F では 32.3 秒、EPYC 9755 では 88.4 秒でした。 DuckDB の報告では、Vera は Intel Xeon 6 ベースラインよりも電力テストで 1.53 ~ 1.61 倍、スループット テストで 1.37 ~ 1.41 倍高速に実行されました。
エージェント コンピューティングを目的とした 88 コア Arm 設計
Vera は 88 個のカスタム オリンパス コアを使用し、空間マルチスレッディングを通じて 176 スレッド、最大 1.2 TB/s の LPDDR5X メモリ帯域幅と最大 1.5 TB のメモリを提供します。 Vera Rubin システムのホスト CPU として、またはエージェント AI、強化学習、データ処理、分析用のスタンドアロン プロセッサとして機能します。 NVIDIA によると、エージェントのワークロードは GPU 推論と CPU ツール実行の間で常に切り替わっており、従来の x86 ホスト プロセッサがボトルネックとなっており、それを取り除くために Vera が再設計されたという。
上記の数値は、独立したサードパーティによる比較ではなく、NVIDIA とそのパートナーによって公開されたテストに基づいたものであり、NVIDIA は Vera の価格を明らかにしていません。 Vera Rubin プラットフォームは 10 月 21 日に本格稼働を開始し、Oracle は 10 月 27 日からクラウド上で Vera Rubin NVL72 システムを提供しています。
(画像:Kad8)
💬 Comments
No comments yet. Be the first!