 N環球

IBMが次世代量子チップNighthawk r3を発表:520量子ビット、2027年には1,000量子ビット以上を目標
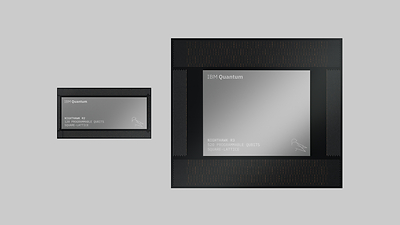
IBMは、520のプログラム可能な量子ビットにわたって10,000の量子演算を正確に実行するように設計された次世代量子プロセッサNighthawk r3を発表しました。 2027 年には、2 つの r3 プロセッサをリンクして 1,040 量子ビットのシステムを構築する予定です。
IBMは火曜日(11月11日)、より大規模で複雑な計算のために520のプログラム可能な量子ビットにわたって10,000の量子演算を正確に実行するように設計された次世代量子プロセッサNighthawk r3を発表した。 2027 年には、2 つの r3 プロセッサを単一の 1,040 量子ビット システムにリンクし、フォールト トレラントな量子コンピューティングに向けて前進する予定です。
r3: 1,000 量子ビットを超えて拡張できるように設計
r3 は、r2 の高速アーキテクチャを拡張し、520 個のプログラム可能な量子ビットと合計 2,034 個の物理量子ビットをサポートするように設計されており、r2 の正方格子接続と高速動作を維持しながら、プロセッサをより大規模なシステムに接続するために l カプラーと呼ばれる 10 個のチップ間相互接続を導入しています。 IBMは、2つの重要なモジュール技術を実証したと述べた。今年は、4つのlカプラーを使用して2つのNighthawk r1プロセッサを接続し、99.3パーセントの量子状態転送忠実度(99.9パーセントの目標に対して)を達成した。また、2つの極低温モジュールを初めて単一システムに接続し、5日未満で動作温度に到達し、15ミリケルビン未満に冷却した。
本番環境の r2: 340 億回路、最大 19 倍のスピードアップ
9月に導入された現在のNighthawk r2は120量子ビットを備え、毎秒最大100,000サンプルを提供し、7,500を超える量子演算による正確な計算をサポートします。 E.ON、Algorithmiq、Q-CTRL を含むクライアントとパートナーは、r2 で 340 億以上の回線を実行し、最大 19 倍の高速化を報告しています。E.ON は、エネルギー グリッド最適化のための量子機械学習で 15 倍の高速化を報告しました。実際の磁性材料をシミュレートするオークリッジ国立研究所とのIBMの実験は12倍高速に実行され、結果は中性子散乱実験と一致しました。また、異種量子材料をシミュレートする Algorithmiq 実験は Heron よりも 8 倍高速に実行されましたが、主要なテンソル ネットワーク手法で古典的にシミュレートするには推定 240 倍のメモリが必要となります。
量子と古典的コンピューティングの出会い
IBM はまた、高性能古典コンピューティングと量子コンピューティングを単一の管理環境である IBM Quantum Platform で統合しています。IBM と理研の科学者は、サンプルベースの量子対角化ワークフローを約 5 倍高速に実行しながら、100 倍多くの計算を実行しました。また、クリーブランド クリニックと理研は、生物学的に関連する構造をモデリングするために 6 億 800 万個のサンプルを 33 倍高速に自動的に処理しました。 IBMは最近、オークリッジ国立研究所およびAMDと量子誤り訂正のための共同設計プラットフォームを立ち上げ、AMD Instinct MI355X GPUおよび第5世代AMD EPYC CPUを搭載したORNLのUmbraスーパーコンピュータとNighthawkを物理的に同じ場所に配置しました。 「有用な量子コンピューティングは、結果を正確かつ迅速に提供できるかどうかにかかっており、どちらも基本的なものです」と IBM Research ディレクターの Jay Gambetta 氏は述べています。
(画像: IBM。Nighthawk r3 (左) および r2 (右) プロセッサーのレンダリング。)
💬 Comments
No comments yet. Be the first!