 N環球

IBM, 차세대 양자 칩 Nighthawk r3 공개: 520큐비트, 2027년 1,000큐비트 이상 목표
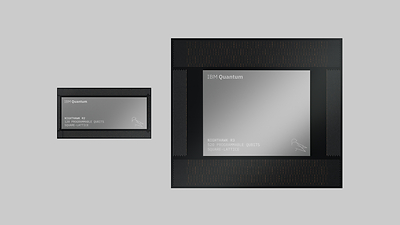
IBM은 프로그래밍 가능한 520개의 큐비트에서 10,000개의 양자 연산을 정확하게 실행하도록 설계된 차세대 양자 프로세서인 Nighthawk r3를 발표했습니다. 2027년에는 두 개의 r3 프로세서를 1,040큐비트 시스템에 연결할 계획입니다.
IBM은 화요일(11월 11일)에 더 크고 복잡한 계산을 위해 프로그래밍 가능한 520개의 큐비트에서 10,000개의 양자 작업을 정확하게 실행하도록 설계된 차세대 양자 프로세서인 Nighthawk r3를 발표했습니다. 2027년에는 두 개의 r3 프로세서를 단일 1,040큐비트 시스템에 연결하여 내결함성 양자 컴퓨팅으로 발전할 계획입니다.
r3: 1,000큐비트 이상으로 확장되도록 설계됨
r3은 프로그래밍 가능한 큐비트 520개와 총 물리적 큐비트 2,034개를 지원하도록 설계된 r2의 고속 아키텍처를 확장하여 r2의 정사각형 격자 연결성과 빠른 작동을 유지하는 동시에 l-커플러라고 하는 10개의 칩 간 상호 연결을 도입하여 프로세서를 더 큰 시스템에 연결합니다. IBM은 두 가지 중요한 모듈식 기술을 시연했다고 밝혔습니다. 올해는 4개의 L-커플러를 사용하여 2개의 Nighthawk r1 프로세서를 연결하여 99.3%의 양자 상태 전송 충실도(99.9% 목표 대비)를 달성했으며, 두 개의 극저온 모듈을 단일 시스템에 처음으로 연결하여 5일 이내에 작동 온도에 도달하고 15밀리켈빈 미만의 냉각을 달성했습니다.
r2 생산 중: 340억 개의 회로, 최대 19배의 속도 향상
9월에 출시된 현재 Nighthawk r2는 120큐비트를 갖추고 초당 최대 100,000개의 샘플을 제공하며 7,500개 이상의 양자 연산으로 정확한 계산을 지원합니다. E.ON, Algorithmiq 및 Q-CTRL을 포함한 클라이언트 및 파트너는 r2에서 340억 개 이상의 회로를 실행하여 최대 19배의 속도 향상을 보고했습니다. E.ON은 에너지 그리드 최적화를 위한 양자 기계 학습 속도가 15배 향상되었다고 보고했습니다. 실제 자성 물질을 시뮬레이션하는 Oak Ridge National Laboratory의 IBM 실험은 12배 더 빠르게 실행되었으며 결과는 중성자 산란 실험과 일치했습니다. 이종 양자 물질을 시뮬레이션하는 Algorithmiq 실험은 Heron보다 8배 빠르게 실행되는 반면, 선도적인 텐서 네트워크 방법을 사용하여 고전적으로 시뮬레이션하려면 약 240배 더 많은 메모리가 필요합니다.
양자가 고전 컴퓨팅을 만나다
IBM은 또한 단일 관리 환경인 IBM 양자 플랫폼에서 고성능 클래식 컴퓨팅과 양자 컴퓨팅을 통합하고 있습니다. IBM과 RIKEN 과학자들은 샘플 기반 양자 대각화 워크플로우를 약 5배 더 빠르게 실행하면서 100배 더 많은 계산을 수행했으며, Cleveland Clinic과 RIKEN은 생물학적으로 관련된 구조를 모델링하기 위해 6억 8백만 개의 샘플을 33배 더 빠르게 자동으로 처리했습니다. IBM은 최근 Oak Ridge National Laboratory 및 AMD와 함께 양자 오류 수정을 위한 공동 설계 플랫폼을 출시했으며, Nighthawk를 AMD Instinct MI355X GPU 및 5세대 AMD EPYC CPU로 구동되는 ORNL의 Umbra 슈퍼컴퓨터와 물리적으로 같은 위치에 배치했습니다. IBM Research 이사인 Jay Gambetta는 "유용한 양자 컴퓨팅은 정확성과 속도로 결과를 제공할 수 있는지 여부에 달려 있습니다. 두 가지 모두 기본입니다."라고 말했습니다.
(이미지: IBM. Nighthawk r3(왼쪽) 및 r2(오른쪽) 프로세서 렌더링.)
💬 Comments
No comments yet. Be the first!