 N環球
Nvidia lança modelos abertos Nemotron 3.5 para agentes corporativos e PCs locais de IA
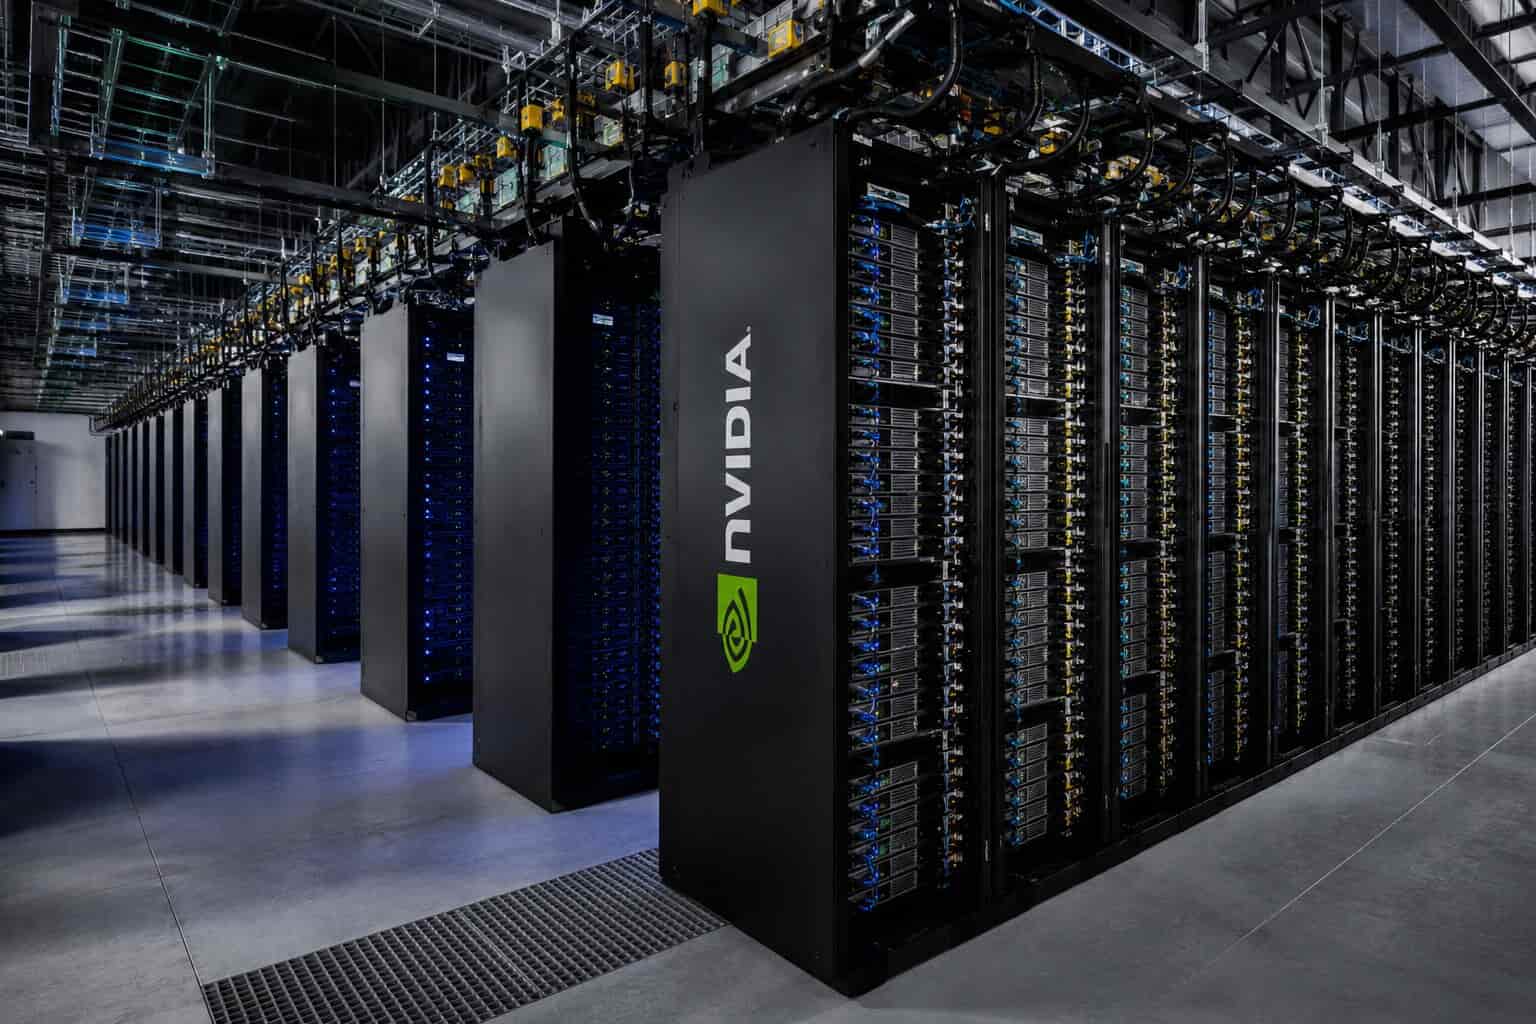
O novo Nemotron 3.5 Super VL de 120 bilhões de parâmetros da Nvidia e dois modelos Bolt leves são fornecidos com pesos abertos, conjuntos de dados e receitas de treinamento, visando agentes sempre ativos na empresa e em PCs de IA locais.
Por que isso importa
A Nvidia está retirando o campo de batalha dos agentes de IA da nuvem para a empresa e para o computador pessoal: toda a família Nemotron 3.5 vem com pesos abertos, conjuntos de dados e receitas de treinamento, para que as empresas possam ajustar e implantar em sua própria infraestrutura com seus próprios dados – um passo fundamental à medida que as empresas exigem soberania e privacidade de dados.
Relatório completo
Em 15 de outubro, a Nvidia lançou a família Nemotron 3.5 de modelos abertos desenvolvidos para agentes sempre ativos e computação de ponta. O carro-chefe, Nemotron 3.5 Super VL, contém 120 bilhões de parâmetros em uma arquitetura mista de especialistas que ativa apenas cerca de 12 bilhões de parâmetros por token. A Nvidia diz que corresponde à precisão de seu modelo de raciocínio maior, Nemotron 3 Ultra, em tarefas de agente de seguimento de instruções e uso de ferramentas.
A empresa também afirma que o Super VL conclui tarefas de agente pós-treinadas mais rapidamente do que modelos comparáveis da Anthropic e OpenAI (Opus 5, GPT 6.1 Sol) e lidera sua classe na tabela de classificação de Análise Artificial com até 5x o rendimento – o tipo de afirmação que acompanha o lançamento de cada fornecedor e precisa de verificação independente. A Nvidia lista os primeiros usuários corporativos, incluindo Skydance, EY, Ramp, Crowdstrike, Perplexity e Salesforce; o modelo está disponível em Hugging Face, OpenRouter, ModelScope e NVIDIA NIM.
Dois modelos Bolt leves têm como alvo a computação local: Nemotron 3.5 Bolt 74B-A9B usa quantização nativa de 2 bits para caber em 24 GB de memória e executa tarefas de agente (raciocínio em várias etapas, chamada de ferramenta, navegação na web) localmente em novos PCs de IA com chips Nvidia RTX Spark e estações de trabalho DGX Spark, agora enviados por meio de parceiros, incluindo Microsoft e Dell. O menor Bolt E4B (4GB), voltado para assistentes de voz e agentes de conversação, será lançado no final deste mês.
O vice-presidente de modelos abertos e software da Nvidia, Kari Briski, disse: “Qualquer organização que queira executar agentes na infraestrutura da Nvidia agora tem um modelo aberto e otimizado para seu nível, sem ter que escolher entre capacidade e implantabilidade”.
💬 Comments
No comments yet. Be the first!