 N環球

Google добавляет автономное распознавание речи и преобразование текста в речь в галерею AI Edge
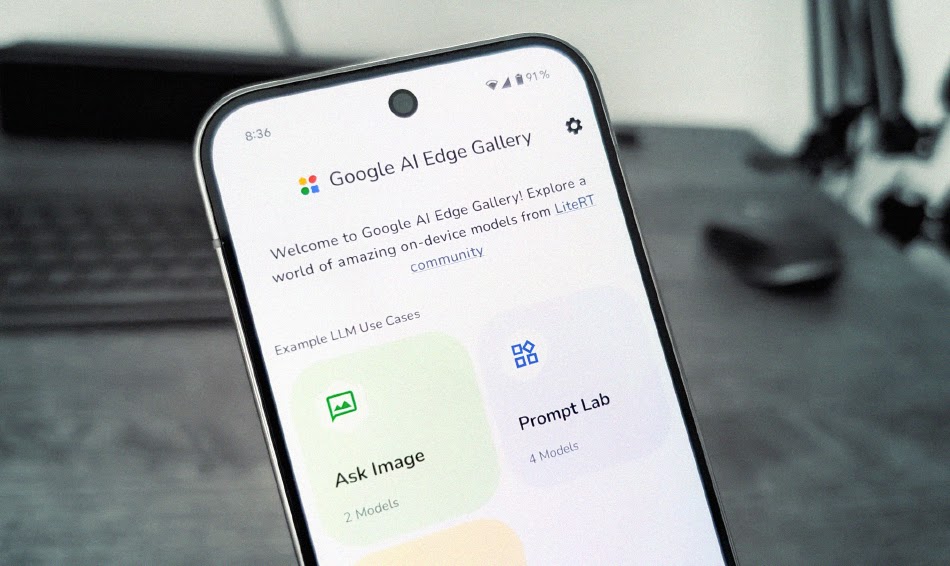
10 ноября Google заявила, что AI Edge Gallery теперь поддерживает автоматическое распознавание речи в автономном режиме и преобразование текста в речь на устройстве в сочетании с небольшими моделями на устройстве, такими как Gemini Nano и Gemma 4, поэтому телефоны могут расшифровывать речь и читать ответы вслух без подключения к сети.
10 ноября Google объявил, что AI Edge Gallery теперь поддерживает автоматическое распознавание речи (ASR) и преобразование текста в речь (TTS) на устройстве в сочетании с небольшими языковыми моделями на устройстве, такими как Gemini Nano и Gemma 4, поэтому телефоны могут транскрибировать речь в реальном времени и синтезировать устные ответы без какого-либо подключения к сети. В Google заявили, что голос часто является наиболее естественным способом взаимодействия с искусственным интеллектом на телефонах и носимых устройствах, а достижения в области компактных речевых моделей теперь делают возможным точное многоязычное ASR и выразительный TTS полностью на устройстве.
Android: ML Kit охватывает более 100 языков и начинает говорить примерно через 100 мс.
На Android новейшие модели речи ML Kit, встроенные в устройство, расшифровывают более 100 языков со скоростью, в 10 раз превышающей скорость в реальном времени, достигая уровня ошибок в словах от 8,0% до 9,0% по тесту FLEURS. Его модель преобразования текста в речь, основанная на компактной диффузионной модели, состоящей из нескольких шагов, начинает говорить примерно через 100 мс и синтезирует звук с частотой 24 кГц со скоростью, в 50 раз превышающей скорость реального времени, для восьми выразительных голосов и 21 языка. Обе модели интегрированы в операционную систему, добавляя 0 МБ к APK-файлу приложения, и получают преимущества от аппаратного ускорения на серверных модулях NPU и TPU, где это возможно.
Кроссплатформенность: модели с открытым весом для iOS, Windows и Интернета.
Для кроссплатформенных приложений Google оптимизировал новые пакеты моделей .litertlm с помощью MediaPipe Tasks и LiteRT, включая Parakeet-TDT 0.6B для распознавания речи и PocketTTS 100M, Kokoro-82M и Phonon 31M для преобразования текста в речь, работающие на iOS, macOS, Windows, Linux и в Интернете, а также модели небольших языков на устройствах без конкуренции за вычислительные ресурсы. Сообщество Hugging Face LiteRT также предлагает модели открытого веса, такие как Whisper и Qwen3-ASR.
Витрины: преподаватель языка офлайн и голосовой чат
Google демонстрирует два варианта использования: демонстрацию XR Language Teacher, которая работает на 100% локально на телефоне, позволяя пользователям наводить камеру на дорожный знак или меню, задавать вопрос вслух и слышать объяснение на своем родном языке с аутентичным произношением на местном языке; и голосовой AI-чат с потоковой диктовкой и воспроизведением вслух с выделением предложений в реальном времени. Эти функции доступны с сегодняшнего дня: приложение AI Edge Gallery для Android и iOS, а исходный код эталонной реализации открыт. Источник: Блог разработчиков Google, 10 ноября 2026 г.
💬 Comments
No comments yet. Be the first!