 N環球

IBM نے اگلی نسل کی کوانٹم چپ Nighthawk r3: 520 qubits کی نقاب کشائی کی، 2027 میں 1,000 سے زیادہ کا ہدف
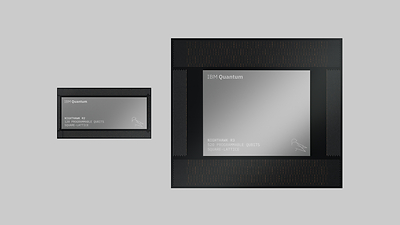
IBM نے اپنے اگلی نسل کے کوانٹم پروسیسر، Nighthawk r3 کا اعلان کیا، جو 520 قابل پروگرام کیوبٹس میں 10,000 کوانٹم آپریشنز کو درست طریقے سے انجام دینے کے لیے ڈیزائن کیا گیا ہے۔ 2027 میں یہ دو r3 پروسیسرز کو 1,040-qubit سسٹم سے منسلک کرنے کا ارادہ رکھتا ہے۔
IBM نے منگل (11 نومبر) کو اپنے اگلی نسل کے کوانٹم پروسیسر، Nighthawk r3 کا اعلان کیا، جو بڑے، زیادہ پیچیدہ کمپیوٹیشنز کے لیے 520 قابل پروگرام کیوبٹس میں 10,000 کوانٹم آپریشنز کو درست طریقے سے انجام دینے کے لیے ڈیزائن کیا گیا ہے۔ 2027 میں یہ دو r3 پروسیسرز کو ایک واحد 1,040-کوبٹ سسٹم سے منسلک کرنے کا ارادہ رکھتا ہے، جو غلطی برداشت کرنے والے کوانٹم کمپیوٹنگ کی طرف بڑھتا ہے۔
r3: 1,000 qubits سے زیادہ پیمانے کے لیے ڈیزائن کیا گیا ہے۔
r3 r2 کے تیز رفتار فن تعمیر کو بڑھاتا ہے، جو 520 قابل پروگرام کیوبٹس اور 2,034 کل فزیکل کوبٹس کو سپورٹ کرنے کے لیے ڈیزائن کیا گیا ہے، r2 کے مربع جالی کنیکٹیویٹی اور تیز آپریشنز کو برقرار رکھتے ہوئے 10 چپ ٹو چپ انٹر کنیکٹس متعارف کراتے ہیں، جنہیں l-cosler to connectors کہا جاتا ہے۔ IBM نے کہا کہ اس نے دو اہم ماڈیولر ٹیکنالوجیز کا مظاہرہ کیا ہے: اس سال اس نے دو Nighthawk r1 پروسیسرز کو چار l-کپلرز کا استعمال کرتے ہوئے جوڑ دیا، 99.3 فیصد کوانٹم اسٹیٹ ٹرانسفر فیڈیلیٹی (99.9 فیصد ہدف کے مقابلے) کو حاصل کیا، اور دو کرائیوجینک ماڈیولز کو جوڑ دیا، اور پانچ دنوں میں درجہ حرارت سے کم درجہ حرارت تک پہنچنے کے لیے دو کرائیوجینک ماڈیولز کو پہلے سے زیادہ درجہ حرارت تک پہنچایا۔ 15 ملی کیلون۔
پیداوار میں r2: 34 بلین سرکٹس، 19x تک کی رفتار
ستمبر میں متعارف کرایا گیا موجودہ Nighthawk r2، 120 کیوبٹس پر مشتمل ہے، فی سیکنڈ 100,000 نمونے فراہم کرتا ہے اور 7,500 سے زیادہ کوانٹم آپریشنز کے ساتھ درست حسابات کی حمایت کرتا ہے۔ کلائنٹس اور شراکت داروں بشمول E.ON، Algorithmiq اور Q-CTRL نے r2 پر 34 بلین سے زیادہ سرکٹس چلائے ہیں، 19x تک کی رفتار کی اطلاع دیتے ہوئے: E.ON نے انرجی گرڈ کی اصلاح کے لیے کوانٹم مشین لرننگ میں 15x اسپیڈ اپ کی اطلاع دی ہے۔ Oak Ridge نیشنل لیبارٹری کے ساتھ IBM کا تجربہ اصلی مقناطیسی مواد کی نقالی کرتے ہوئے 12x تیزی سے چلا، جس کے نتائج نیوٹران بکھرنے والے تجربات کے مطابق تھے۔ اور ایک الگورتھمک تجربہ جس میں ایک متضاد کوانٹم مواد کی نقل ہیرون کے مقابلے میں 8 گنا زیادہ تیزی سے چلائی گئی، جبکہ ٹینسر نیٹ ورک کے معروف طریقوں کے ساتھ کلاسیکی طور پر اس کی تقلید کرنے کے لیے اندازے کے مطابق 240 گنا زیادہ میموری کی ضرورت ہوگی۔
کوانٹم کلاسیکی کمپیوٹنگ سے ملتا ہے۔
IBM ایک واحد منظم ماحول میں کوانٹم کمپیوٹنگ کے ساتھ اعلی کارکردگی والے کلاسیکی کمپیوٹنگ کو بھی یکجا کر رہا ہے، IBM کوانٹم پلیٹ فارم: IBM اور RIKEN کے سائنسدانوں نے اپنے نمونے پر مبنی کوانٹم ڈائیگنلائزیشن ورک فلو کو تقریباً 5 گنا زیادہ تیزی سے انجام دیا جبکہ 100 گنا زیادہ کمپیوٹنگ اور خود کار طریقے سے CVEN00 ملین Clivenc اور CLIKEN کے عمل کو مکمل کیا۔ حیاتیاتی لحاظ سے متعلقہ ڈھانچے کی ماڈلنگ کے لیے نمونے، 33 گنا تیز۔ IBM نے حال ہی میں Oak Ridge نیشنل لیبارٹری اور AMD کے ساتھ کوانٹم ایرر درست کرنے کے لیے ایک مشترکہ ڈیزائن پلیٹ فارم کا آغاز کیا، جس میں ORNL کے Umbra سپر کمپیوٹر کے ساتھ Nighthawk کو جسمانی طور پر شریک کیا گیا، AMD Instinct MI355X GPUs اور 5th Gen AMD EPYC CPUs سے تقویت یافتہ۔ IBM ریسرچ کے ڈائریکٹر جے گیمبیٹا نے کہا کہ "مفید کوانٹم کمپیوٹنگ اس بات پر منحصر ہے کہ آیا نتائج درستگی اور رفتار کے ساتھ فراہم کیے جا سکتے ہیں، دونوں بنیادی ہیں۔"
(تصویر: IBM. نائٹ ہاک r3 (بائیں) اور r2 (دائیں) پروسیسرز کا رینڈر۔)
💬 Comments
No comments yet. Be the first!