 N環球

中国安纳智芯发布 AX100 类比晶片 单次解矩阵方程不到 100 奈秒
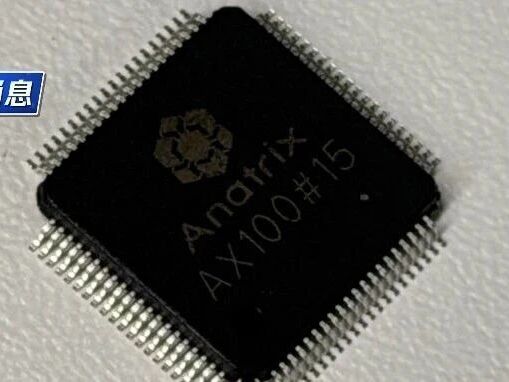
安纳智芯称 AX100 是世界首颗全集成一步求解矩阵方程的类比计算晶片,10 月已完成流片,单次求解不到 100 奈秒、功耗约 80 毫瓦,可用成熟制程生产。
中国模拟计算晶片公司安纳智芯(Anatrix)11 月 15 日宣布,自主研发的 AX100 晶片已于 10 月完成流片。公司称,这是世界首颗全集成一步求解矩阵方程的模拟计算晶片,测试显示单次矩阵方程求解时间小于 100 奈秒,单次计算功耗约为 80 毫瓦,符合理论仿真与设计预期。消息由《科技日报》率先报导。
矩阵变电路 一次读出答案
矩阵方程是人工智慧模型训练、机器人动作控制和无线通讯讯号处理背后的核心数学问题。传统数位晶片要靠一连串逐步运算求解,AX100 则把矩阵方程直接映射为电路,电路自行达到平衡后一次读出结果,无需迭代。安纳智芯行政总裁向锐表示,AX100 与 GPU 类数位晶片在架构和底层逻辑上完全不同,具备现代模拟计算的顶尖计算能力。
三个场景的测试数据
安纳智芯在三个场景下测试了这款晶片。在人工智慧训练中,以一个 293 万参数的自编码器模型和一个 272 万参数的 Transformer 模型验证,模型参数更新的计算成本分别降低 92% 和 56%。在具身智慧方面,测试显示机器人的运动控制和路线规划更快,有助机器人对环境变化作出更即时反应。在无线通讯方面,针对 128×128 规模的通道格拉姆矩阵,模拟计算晶片相比现有数位 ASIC 晶片与 GPU 的等效吞吐提升 20 至 207 倍,等效能效提升 27.6 至 61.3 倍。
源自北大研究 可用成熟制程生产
AX100 的技术源自北京大学人工智慧研究院孙仲团队 2025 年 10 月发表于《自然・电子学》的研究。该团队把模拟计算的精度从此前的百分之一量级提升到千万分之一量级,单次矩阵方程求解比先进 GPU 快 3 个数量级、能效高 2 个数量级。论文发表仅一年,安纳智芯便把这项技术从实验室推向产线。公司表示,AX100 可以用成熟的晶片制造工艺生产,无需最先进制程。
需要留意的是,「世界首颗」的说法及上述测试数据均为安纳智芯的公司说法,尚未经过独立验证;完成流片也不等于量产。晶片能否在大规模实际应用中保持同样的精度与效率,仍有待进一步的公开测试与产业验证。
💬 留言
暂时还没有留言,来抢沙发!