 N環球

英伟达 Vera Rubin 横扫 MLPerf 训练测试 智能体推理能效号称十倍于上代
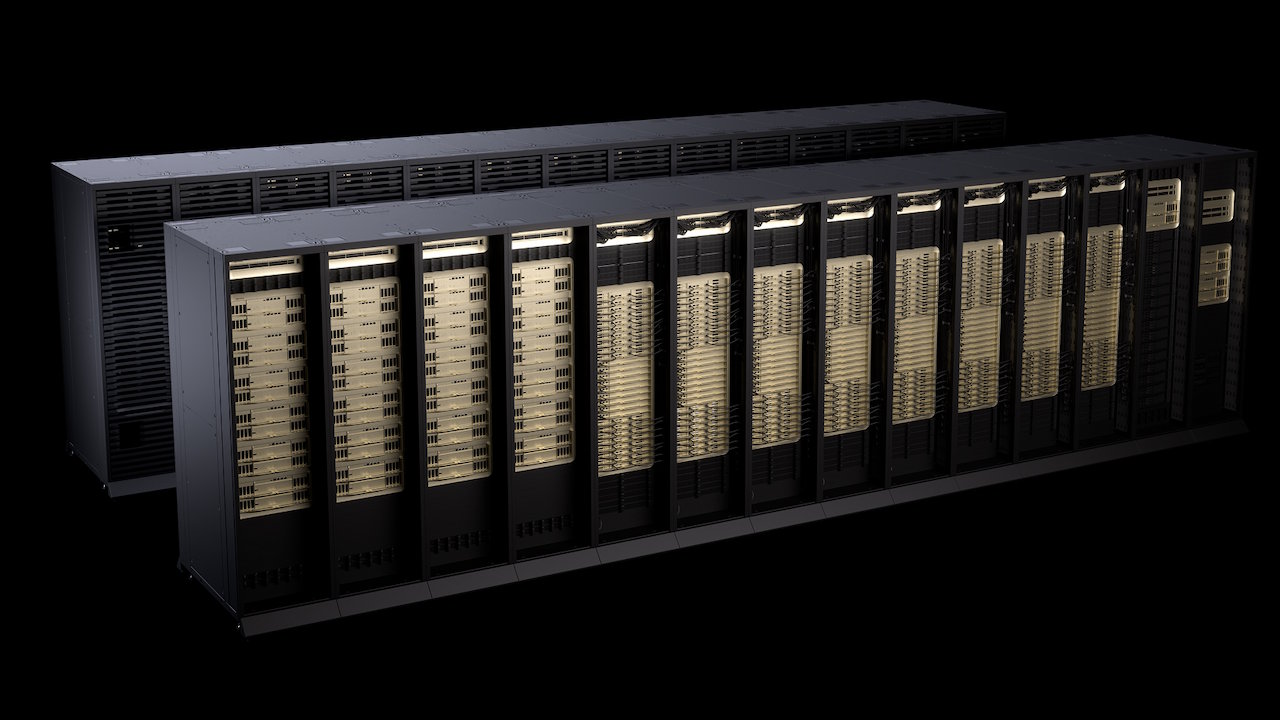
英伟达11月16日公布,Vera Rubin 平台在 MLPerf Training v6.1 全部测试中夺冠,首次提交的 MLPerf Endpoints 智能体推理成绩更号称每瓦吞吐量较上代 GB300 高出十倍以上;不过智能体端数字仍属暂定,尚待 MLCommons 验证。
英伟达11月16日在芝加哥超级计算大会SC26期间公布,Vera Rubin 平台在 MLPerf Training v6.1 全部测试项目中夺冠,成为本轮唯一在每个测试都有成绩的平台;首次提交的 MLPerf Endpoints 智能体推理成绩,暂定数字显示每瓦吞吐量较上代 GB300 NVL72 高出十倍以上。成绩由英伟达官方博客发布,MLCommons 同日公布本轮完整结果。
训练测试:全数夺冠,扩展效率约 97%
MLPerf Training 衡量系统把各类人工智能模型训练到目标准确率的速度,涵盖大语言模型、图像生成、推荐系统与训练后强化学习。本轮 Vera Rubin NVL72 单颗图形处理器的表现较高度优化的 GB300 NVL72 最高高出一倍。在 DeepSeek-V3 测试中,Vera Rubin 由 256 颗扩展至 1,024 颗图形处理器,效率维持约 97%,训练时间由 16 分钟缩短至约 4 分钟。英伟达亦以 GB300 系统跑出 10,240 颗图形处理器的测试,是本轮最大规模。
智能体推理:十倍数字仍待验证
在首次提交的 MLPerf Endpoints 测试中,英伟达以开源智能体模型 Kimi K3 作暂定成绩:32 个加速器的 Vera Rubin NVL72 系统吞吐量为每秒 41,414.2 个词元、功耗 100.89 千瓦;对比 48 个加速器的 GB300 NVL72 每秒 2,210.4 个词元、功耗 60 千瓦。英伟达在官方博客中明确标注,Vera Rubin 的智能体端数字属暂定、尚待 MLCommons 协会验证,经同行评审后可能有变;GB300 的数字则已获验证。读者应把十倍能效理解为厂商公布的暂定成绩,而非已核实的最终结果。
本轮规模与云端厂商成绩
MLCommons 表示,Training v6.1 共有 24 个机构提交、153 套系统、250 项成绩,新增推荐系统 DLRMv4-HSTU 与大规模语言模型训练后测试 Qwen3.5-397B 两项;参赛硬件除英伟达、AMD 外,首次出现 Rubin 世代图形处理器与 Google TPUv7(Ironwood)。云端厂商 CoreWeave 同日宣布,成为首家提交多机架 Vera Rubin 成绩的云服务商:以 256 颗 Rubin 图形处理器在 17.65 分钟内完成 6,710 亿参数 DeepSeek-V3 训练,较自家 GB200 同规模成绩快 2.7 倍;单机架 72 颗 Rubin 则在 7.16 分钟完成 Llama 3.1 8B,较 GB200 快 1.9 倍。CoreWeave 亦注明,其倍数由已公布成绩自行推算,未经 MLCommons 验证。
背景:财报前夕的关键一周
这是英伟达在 SC26 的第二波重磅发布,本轮早前已推出科研智能体工具 Nemotron for Science。英伟达将于 11 月 17 日星期二公布季度业绩,是创办人黄仁勋 11 月 12 日辞任行政总裁、财务总监科莱特·克雷斯出任临时行政总裁后的首份业绩;市场关注新平台的出货进度与需求口径,MLPerf 成绩被视为公司在财报前展示技术领先地位的一步。
💬 留言
暂时还没有留言,来抢沙发!