 N環球

超微联手IBM与辉达推KV快取储存 长文本AI推论首字回应快56倍
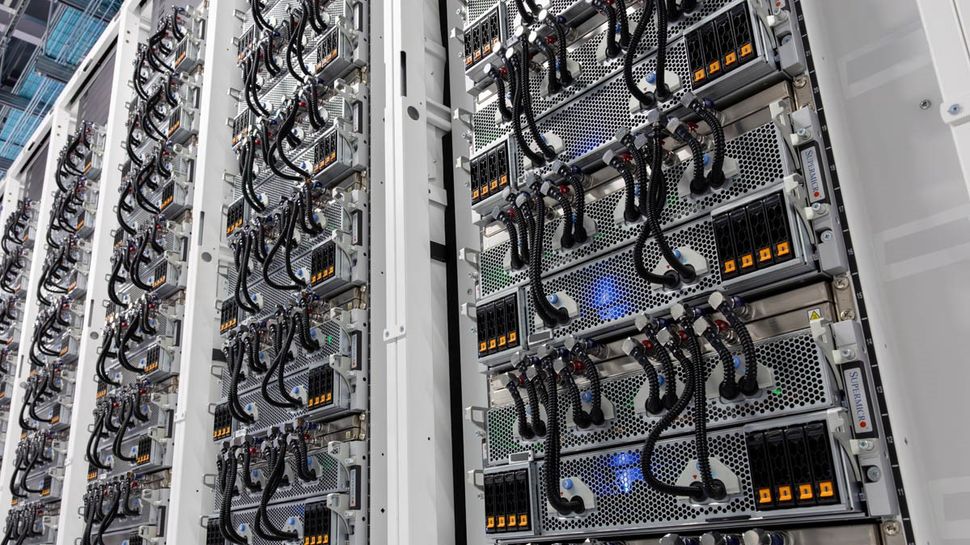
超微今日宣布与IBM、辉达合作推出KV快取储存方案,把AI推论中可重复使用的上下文从GPU记忆体搬到共享储存;联合测试显示,13万字元提示的首字回应时间最快可提升56倍。
美国伺服器大厂超微(Supermicro)今日(11月5日)宣布,与IBM及辉达(NVIDIA)合作推出KV快取(KV cache)储存方案,把AI推论中可重复使用的上下文从GPU记忆体搬到共享储存。联合测试显示,在13万字元(token)的提示下,首字回应时间最快可提升56倍。(图片:AI数据中心资料图片。)
把推论上下文搬出GPU记忆体
这套方案整合超微Petascale全快闪储存伺服器(采用AMD EPYC 9005系列处理器)、IBM Storage Scale软体、辉达Dynamo推论框架,以及辉达Spectrum-X乙太网路。IBM Storage Scale的纠删码版本(Erasure Coding Edition)提供辉达记忆体层级中的共享G4储存层,让多台GPU伺服器共用同一份推论上下文,不必每张卡各自重算。
13万字元提示 重算32秒变0.57秒
根据IBM红皮书(Redbooks)参考架构的量测,13万字元提示若由GPU重新计算需32.14秒,改用储存端快取只需0.57秒。联合测试以一台配备4张辉达RTX PRO 6000 GPU的超微客户端节点,连接8节点Petascale储存丛集完成,软体堆叠包括Dynamo 0.9.0以上版本、vLLM 0.14.1,测试模型为openai/gpt-oss-120b。
超微表示,方案针对长上下文推论与代理式(agentic)工作负载设计,随著提示愈来愈长、对话历史愈来愈多,快取能避免重复计算、降低延迟与成本。需要留意的是,56倍是特定测试条件下的首字回应时间对比,并非所有提示长度或模型都可达到同一幅度。
(来源:超微/PR Newswire、Unite.AI,2026年11月5日。)
💬 留言
暂时还没有留言,来抢沙发!